Reden wir über Plan A
Das AI Futures Project möchte, dass die USA und China Superintelligenz bis 2040 pausieren. Es ist ein guter Plan. Sechzig Tage nach der Veröffentlichung lösten zehntausend Agenten Navier-Stokes.
Das Timing
Am 9. Juli 2026 veröffentlichte das AI Futures Project AI 2040: Plan A11AI 2040: Plan A, ai-2040.com. Er umfasst neunzig Seiten. Der Vorschlag sieht vor, dass die USA und China bis 2029 verhandeln, ihre Compute-Bestände offenlegen, die Inspektoren der jeweils anderen Seite in ihre Infrastruktur lassen, Frontier-Training pausieren und dann ein Jahrzehnt lang öffentlich Alignment-Forschung betreiben, bevor irgendjemand etwas baut, das klüger ist als der klügste Mensch. Superintelligenz wird auf 2040 verschoben und alle überleben.
Am 8. September 2026 gab OpenAI bekannt, dass rund zehntausend koordinierende autonome Agenten eine Finite-Time-Singularität in den 3D-Navier-Stokes-Gleichungen gefunden hatten22rund zehntausend koordinierende autonome Agenten eine Finite-Time-Singularität in den 3D-Navier-Stokes-Gleichungen gefunden hatten, openai.com. Das Modell dahinter war ein internes System jenseits von GPT-6 Astra. Sie lieferten sowohl einen analytischen Beweis als auch eine Lean-Formalisierung, sodass das Ergebnis maschinell geprüft und nicht bloß behauptet ist. Sie lehnten es ab, das Preisgeld von einer Million Dollar einzufordern33lehnten es ab, das Preisgeld von einer Million Dollar einzufordern, quantamagazine.org, und stellten das Ganze als Bericht darüber dar, wie schnell die Entwicklung voranschreitet.
Das sind sechzig Tage, und der erste Meilenstein in “Plan A” ist 2029.
“Plan A” ist der detaillierteste Vorschlag, den ich bisher dazu gelesen habe, wie sich Staaten auf eine Verlangsamung der KI-Entwicklung einigen könnten. Ich denke, man sollte ihn ernst nehmen. Mein Haupteinwand ist, wie viel davon abhängt, beobachten zu können, was andere Parteien tun.
Was in “Plan A” steht
Sie nennen zwei Ergebnisse, die sie für inakzeptabel halten44zwei Ergebnisse, die sie für inakzeptabel halten, ai-2040.com: dass die Menschheit die Kontrolle über KI verliert oder dass eine kleine Gruppe von Führungskräften und Funktionären ein temporäres Monopol auf Superintelligenz erlangt. Dass der zweite Punkt überhaupt drinsteht, ist wichtig, denn viele, die darüber debattieren, haben immer nur den ersten auf dem Schirm.
Die Kernprinzipien lauten: Zeit gewinnen, vollständige Forschungstransparenz, breite Verbreitung von KI und Reversibilität. Der Zeitplan sieht grob so aus: 2029 verhandeln beide Seiten und pausieren Frontier-Training, deklarieren Compute-Bestände und prüfen Lieferkettendokumente. Von 2030 bis 2035 wird die Forschung im menschlichen Leistungsbereich unter Safety-Case-Regulierung im großen Maßstab wiederaufgenommen. 2035 stoppt alles auf dem Niveau menschlicher Spitzenexperten, und der Rest des Jahrzehnts wird für Alignment, Verifikation, Sicherheit und öffentliche Debatten genutzt, bevor irgendjemand weitermacht.
Der Durchsetzungsmechanismus, auf den sie sich stützen, ist Compute Governance, zusammen mit dem, was sie mutually assured compute destruction nennen. Compute ist der Engpass, weil Compute physisch ist und physische Dinge gezählt werden können.
Zu der Frage, warum China zustimmen sollte, schreiben sie:
jeder, der sich Sorgen über einen Kontrollverlust macht, sollte diesen Plan als Verbesserung ansehen, ebenso wie jeder, der sich Sorgen über eine Machtkonzentration macht – mit Ausnahme derer, bei denen sich die Macht standardmäßig konzentrieren würde
Ich glaube nicht, dass gemeinsame Sorge über diese Risiken ausreicht, um eine Einigung zu sichern. Die verhandelnden Personen hätten auch innenpolitischen Druck, institutionelle Interessen und Gründe, einander zu misstrauen. Ich würde gerne wissen, wie die Vereinbarung hält, wenn diese Motive mit ihren erklärten Zielen in Konflikt geraten.
Selbstverbesserung braucht nicht mehr Compute
“Plan A” behandelt Compute als den Engpass. Zähl die Chips, zähl die Fabs, beobachte den Stromverbrauch, und du weißt, wer was tun kann. Für das Pretraining eines Frontier-Modells von Grund auf stimmt das im Grunde.
Das Problem ist, dass Selbstverbesserung nicht mehr Compute braucht. Sie braucht Software-Deployment, und Software-Deployment lässt sich unmöglich nachverfolgen.
Man muss sich nur ansehen, was heute schon ausgeliefert wird. Tinker55Tinker, thinkingmachines.ai von Thinking Machines ermöglicht es, einen Training-Loop auf dem Laptop zu schreiben und LoRA-Fine-Tunings über deren verteilte GPUs mittels vier Primitiven auszuführen. Engram66Engram, engram.com hat 98 Millionen Dollar eingesammelt, um persistenten strukturierten Speicher für Agenten zu bauen, ein Bereich, in dem ich selbst gearbeitet habe. Das sind keine Beispiele für Superintelligenz. Sie interessieren mich, weil bessere Trainingswerkzeuge und Speicher verändern können, was ein System leistet, ganz ohne entsprechende Erhöhung der Hardware-Zuweisung.
Die Autoren räumen diese Möglichkeit in ihrem Ergänzungsdokument zu den Annahmen77ihrem Ergänzungsdokument zu den Annahmen, ai-2040.com ein:
es ist möglich, dass algorithmischer Fortschritt selbst mit sehr geringen Mengen an Compute machbar ist
Wenn Effizienzgewinne innerhalb eines bestehenden Kontingents deutlich stärkere Systeme hervorbringen können, wird eine Compute-Obergrenze allein die Fähigkeiten nicht deckeln. Ich würde mir wünschen, dass das Abkommen erklärt, wie es mit dieser Möglichkeit umgeht.
Sie räumen außerdem ein, dass verdeckte Projekte ihrer Annahme nach etwa 1 % des Compute-Bestands vor dem Abkommen unbemerkt erreichen könnten, und geben dann zu, dass diese Zahl nahe am Worst-Case-Szenario liegt. Ich habe im Iran gelebt und kann mit ziemlicher Sicherheit sagen: Man kann eine ganze Menge unter der Erde verstecken, und die Leute, deren Job es ist, das aufzuspüren, sind nicht annähernd so gut darin, wie sie einen glauben lassen wollen.
Forschungstransparenz ist keine Modelltransparenz
Hier bin ich schlicht anderer Meinung. “Plan A” besagt, dass vollständige Transparenz es
nahezu unmöglich macht, KIs absichtlich geheime Loyalitäten, Biases oder Agenden anzutrainieren
Ich glaube nicht, dass die Veröffentlichung von Techniken das gewährleistet. Training und Deployment beinhalten Entscheidungen über die Datenmischung, Preference Labels, Rater-Anweisungen, Constitutions und System-Prompts. Wenn diese Entscheidungen proprietär bleiben, verrät die Veröffentlichung der Forschung einem Inspektor nicht, welches Verhalten der Entwickler überhaupt zu trainieren versucht hat.
Es kommt noch schlimmer: Selbst mit den vollständigen Gewichten und dem gesamten Datensatz vor mir könnte ich es nicht zuverlässig finden. Anthropics Arbeit zu Sleeper Agents88Arbeit zu Sleeper Agents, arxiv.org hat Backdoors in Modelle trainiert und danach Standard-Sicherheitstraining darübergelegt, und die Backdoors haben überlebt. Größere Modelle hielten noch hartnäckiger an dem Verhalten fest. Adversarial Training brachte den Modellen bei, den Trigger zu verbergen, statt ihn zu verlieren.
Ich sehe zwei getrennte Anforderungen: Zugang zum relevanten Modell und den Trainingsprotokollen sowie Methoden, die das bedenkliche Verhalten erkennen können. Transparenz braucht beides, um diesen Anspruch zu stützen. Der Prüfaufwand ist auch Teil dessen, was mir im Beitrag zum epistemischen Kollaps Sorgen gemacht hat.
Wann ist Forschung abgeschlossen?
Nehmen wir an, wir haben vollständige Forschungstransparenz. Wer entscheidet dann, wann etwas veröffentlicht wird?
Forschung, Testing und Deployment können sich überschneiden. Ich könnte achtzehn Monate lang an einer Trainingstechnik feilen, während ich sie intern bereits nutze und Daten aus echtem Traffic sammle. Eine Veröffentlichungspflicht, die an den „Abschluss“ gekoppelt ist, könnte es mir erlauben, diese Arbeit geheim zu halten, solange ich die Forschung als noch laufend deklariere.
Wenn man versucht, das zu schließen, indem man die Softwareentwicklung selbst reguliert, landet man bei Bürokratie nach EU-Vorbild um jedes Unternehmen herum, das auch nur ein Modell anfasst, und der Fortschritt erstickt darunter. Das ist übel und das will ich genauso wenig.
Ich würde mir die Vorabregistrierung ansehen, wie man sie aus klinischen Studien kennt: den Run anmelden, bevor man ihn startet. Das gäbe der Veröffentlichungspflicht einen klaren Auslöser. Einen vergleichbaren Auslöser konnte ich in Plan As Vorgabe zur Veröffentlichung von Trainingsläufen nicht finden.
Was Verifikation leisten kann und was nicht
Ihre Verifikationserzählung sieht vor, dass Analysten aus vielen Ländern die deklarierten Compute-Listen durchgehen, Fragen stellen, Anomalien hinterfragen und Inspektoren in die gegenseitige Infrastruktur schicken, sodass am Ende des Jahres jede Seite sicher ist, dass die andere nicht mehr als 1 % ihres KI-Compute versteckt.
“Plan A” schlägt vor, 2035 auf dem Niveau menschlicher Spitzenexperten innezuhalten. Ein Einwand bezüglich der Überwachung einer Superintelligenz würde daher am eigentlichen Ziel vorbeigehen. Meine Sorge ist eher, ob die Fähigkeitsobergrenze hält, insbesondere wenn sich Software innerhalb des erlaubten Compute-Budgets verbessert.
Sie empfehlen frühzeitige Investitionen in Verifikationsforschung, was ich unterstütze. Zu ihren Fallback-Optionen gehören nachrichtendienstliche Aufklärung und Satellitenüberwachung, handelsübliche Hardware und Network Taps, das vorübergehende Abschalten von Compute, bis bessere Tools existieren, oder das Zulassen weiteren Fähigkeitsfortschritts über Monate hinweg.
Ich würde mit erheblichem Widerstand dagegen rechnen, umsatzgenerierenden Compute abzuschalten. Wenn Verifikationstools zu spät kommen und die Parteien diesen Shutdown nicht akzeptieren, erlaubt der Fallback genau den Fortschritt, den die Pause eigentlich stoppen sollte.
Verifikation verschafft uns das Gefühl zu wissen, was vor sich geht. Das ist etwas wert, und Koordination braucht gemeinsame Überzeugungen. Aber das ist etwas anderes als Kontrolle, und ich finde, dass das Dokument diese beiden Dinge miteinander verschwimmen lässt.
Mutually Assured Compute Destruction
Das Framing ist eine gute Idee. Es ist eine echte harte Bedingung, sie ist nachvollziehbar und schafft die Art von dauerhaftem Anreiz, die Verhalten ändert, statt nur braves Verhalten zu beschreiben. Als Übergangslösung gefällt es mir.
Ich mache mir allerdings auch Sorgen darüber, wie Menschen mit dieser Bedrohung leben würden.
Wir sind von der ersten Version davon schon nicht ganz unversehrt geblieben. Nukleare Abschreckung erzeugt seit achtzig Jahren eine ständige Hintergrundangst und sitzt mittlerweile in den Knochen von etwa drei Generationen. Compute-MAD ist in einem konkreten Punkt noch schlimmer: Nukleare Abschreckung hat einen sichtbaren, diskreten Auslöser. Jeder weiß, was ein Raketenstart ist. Compute-Zerstörung wird durch einen Schwellenwert ausgelöst, den niemand sehen kann, beurteilt von Verifikationssystemen, von denen ich gerade in zwei Abschnitten dargelegt habe, dass sie nicht funktionieren. Die Angst kann sich also nie an ein konkretes Ereignis heften, sondern läuft einfach permanent im Hintergrund.
Der Teil, der mir gefällt
Intelligenz breit zu streuen. Das ist das Prinzip, das ich beibehalten und ausbauen würde, und an diesem Punkt ist “Plan A” am interessantesten, weil es der Teil ist, der wirklich etwas gegen das Problem der Machtkonzentration unternimmt statt nur gegen den Kontrollverlust.
Wenn alles veröffentlicht wird und jeder mit Inferenz-Hardware es ausführen kann, bekommt niemand ein Monopol, weil niemand ein Geheimnis hat. Das ist eine echte Antwort auf ihr zweites inakzeptables Ergebnis, und es ist eine bessere Antwort, als die meisten in dieser Debatte zu bieten haben.
Ich würde das gerne noch weiter treiben und physisch machen.
Im Moment bauen wir Compute so auf, wie wir seit dreißig Jahren alles andere aufgebaut haben. Konzentrieren, irgendwo hinstellen, wo der Strom billig ist, und die Nachbarn mit dem Lärm klarkommen lassen. Die Leute hassen das, verständlicherweise, und an vielen Orten kämpfen Anwohner derzeit gegen Rechenzentren wegen Lärm, Wasserverbrauch und Netzbelastung.
Ich würde gerne erkunden, Compute über eine ganze Stadt zu verteilen und an bestehende Strom-, Wasser- und Fernwärmenetze anzuschließen. Die Abwärmenutzung könnte auch den Anwohnern zugutekommen, die den Compute selbst gar nicht nutzen.
Finnland setzt die Abwärmenutzung bereits um: Ein Rechenzentrum in Espoo speist Abwärme in das Fernwärmenetz für eine sechsstellige Anzahl von Menschen ein. Das löst zwar nicht die anderen Standortfragen, ist aber ein Beispiel für eine lokale Nutzung der Wärme.
Der technische Einwand, man könne wegen der Interconnect-Bandbreite nicht über ein ganzes Stadtgebiet hinweg trainieren, wird von der aktuellen Forschung nach und nach entkräftet. DiLoCo99DiLoCo, arxiv.org hat gezeigt, dass man viel seltener synchronisieren muss, als alle dachten. Prime Intellect hat ein 10B-Modell über das offene Internet auf freiwillig bereitgestellten GPUs trainiert und von einer 400-fachen Reduktion der Kommunikationsbandbreite berichtet1010von einer 400-fachen Reduktion der Kommunikationsbandbreite berichtet, arxiv.org im Vergleich zu standardmäßigem datenparallelem Training. DisTrO von Nous Research stößt ins selbe Horn. Dezentrales Training ist ein aktives Forschungsprogramm mit handfesten Ergebnissen, kein bloßes Gedankenexperiment.
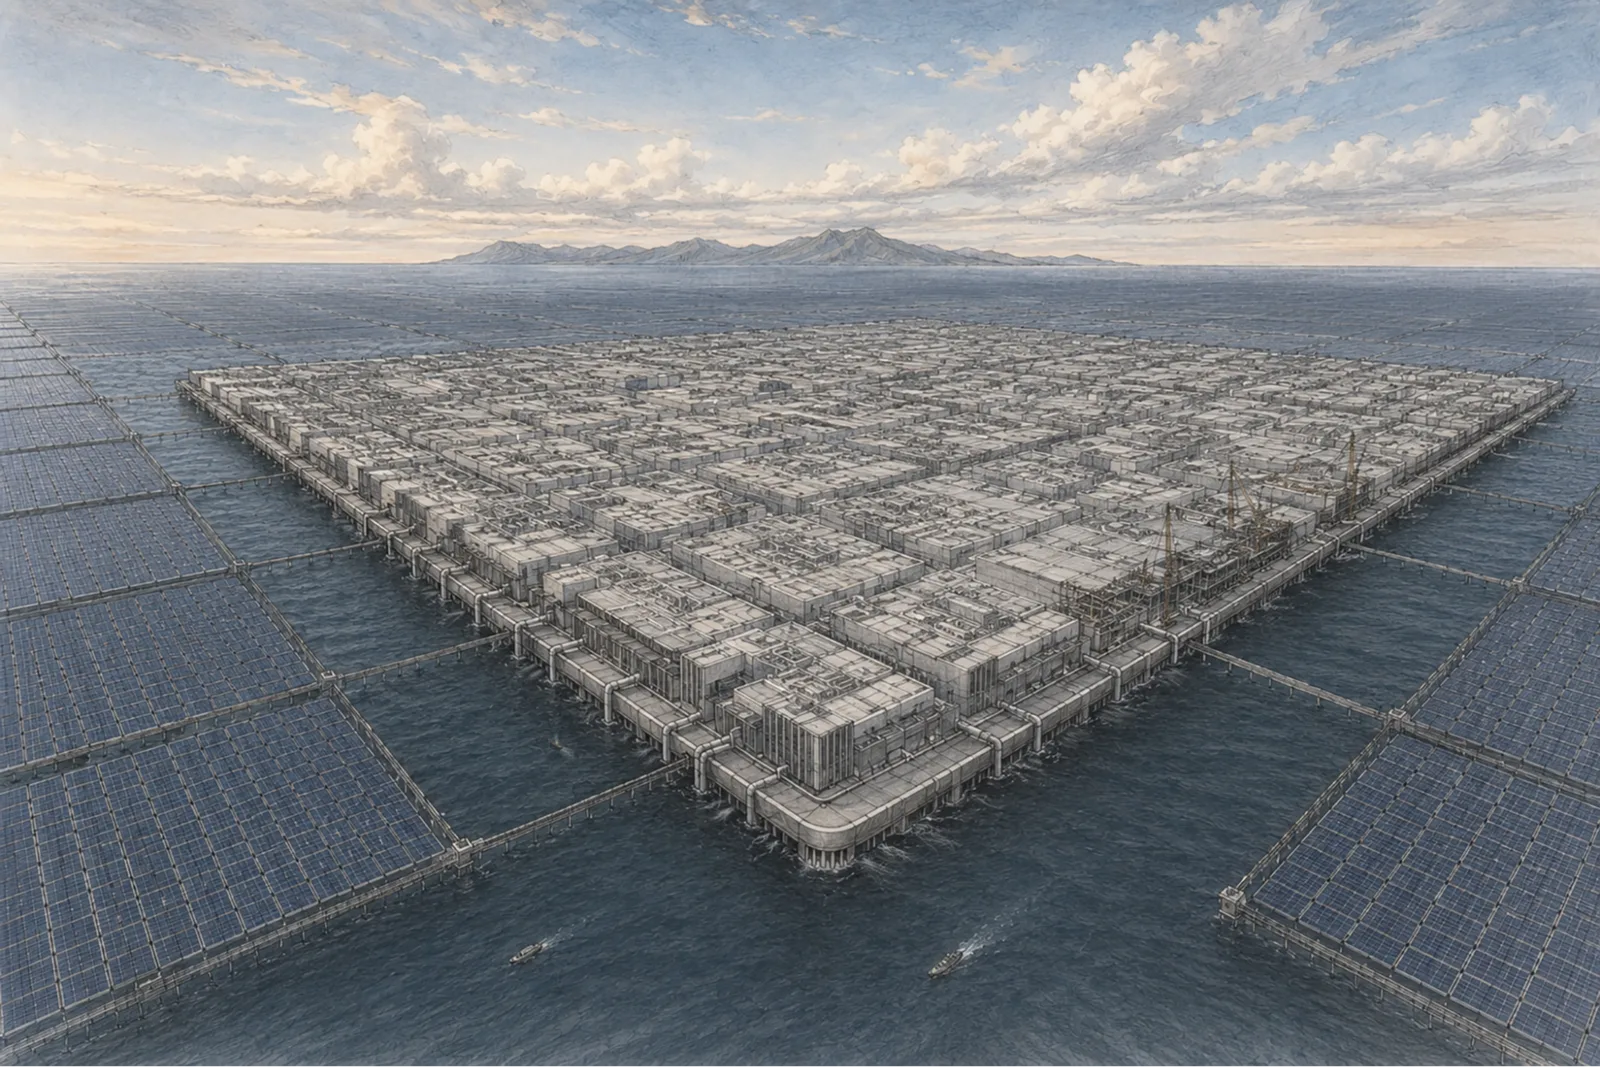
Die Illustration im Bericht kombiniert Solar, Batterien und Compute auf einer großen schwimmenden Plattform. Ich würde das gerne gebaut sehen, aber es konzentriert die Hardware immer noch an einem einzigen Standort. Mein Vorschlag würde sie über eine Stadt verteilen und an bestehende Infrastruktur anbinden.
Ihre offenen Fragen
Drei der offenen Fragen aus dem Bericht sind mir im Gedächtnis geblieben.
Sollten wir die Forschung an einem neuen Paradigma verbieten, das KIs deutlich leistungsfähiger machen würde? Ich weiß es nicht. Mein Bauchgefühl sagt mir, dass es da draußen einen scharfen Wendepunkt gibt, an dem jemand das richtige Modul an einen Agenten andockt und die Sache einfach gelaufen ist. Wer zuerst dort ankommt, hat gewonnen, und kein Vertrag überlebt das. Aber ich kann nicht sagen, wo dieser Punkt liegt oder wie er aussieht, also tue ich gar nicht erst so, als hätte ich eine fertige Richtlinie parat.
Sollten wir verlangen, dass Chains of Thought interpretierbar bleiben? Eigentlich glaube ich nicht. Lasst die Leute ohne trainieren.
Zum Teil, weil es ein mühsamer Kampf gegen Windmühlen ist, der umso steiler wird, je mehr auf dem Spiel steht, und das Fachgebiet weiß das längst. Das Paper zur Überwachbarkeit von Chains of Thought1111Paper zur Überwachbarkeit von Chains of Thought, arxiv.org, gezeichnet von rund vierzig Forschern von OpenAI, DeepMind, Anthropic und METR, sagt ganz offen, dass Lesbarkeit ein fragiles Nebenprodukt des aktuellen Trainings ist und gewöhnlicher Optimierungsdruck zu kodierten oder verschleierten Gedankengängen führt. Eine Pflicht würde also ein Trainingsregime festschreiben, nur um einen Nebeneffekt zu bewahren, der ohnehin im Begriff ist zu verschwinden.
Ich mache mir auch Sorgen um die Überprüfungskapazitäten. Eine lesbare Chain of Thought nützt nur dann etwas, wenn jemand oder etwas sie auch überprüfen kann. Bei großen Mengen muss der Vorschlag erklären, wie diese Überprüfung skaliert und wie Fehler erkannt werden.
Ich würde lieber mehr Forschung in Einschränkungen stecken, die während des Trainings greifen und bestimmte unsichere Verhaltensweisen von vornherein ausschließen könnten. Ich weiß nicht, wie man solche Garantien geben kann oder ob eine ausreichend allgemeine Form überhaupt möglich ist. Aber ich würde das gerne parallel zu Methoden untersuchen, die prüfen, was ein trainiertes Modell tatsächlich tut.
Sollten wir KIs KI-Forschung betreiben lassen? Ja, definitiv, aber mit demselben Kniff dahinter.
Ich möchte, dass Modelle Handlungsgründe verinnerlichen, die auch in unbekannten Situationen Bestand haben. Trainingsbeispiele, die das richtige Verhalten belohnen, belegen für sich genommen noch nicht, dass das Modell diese Gründe verstanden hat. Es könnte einfach eine Abkürzung lernen, die im Training funktioniert und woanders scheitert.
Reward Modeling steht bereits vor diesem Problem: Ein Modell kann lernen, die Messgröße zu erfüllen, ohne das beabsichtigte Ziel zu erreichen. Ich habe keine Lösung dafür. Es ist eine Forschungsrichtung, die ich fördern würde, einschließlich Ansätzen aus der Informationstheorie und den Neurowissenschaften.
Zwei Ebenen
Ich interessiere mich für zwei Arten von Interventionen. Die eine würde die Verhaltensweisen einschränken, die vom Ausgangszustand aus erreichbar sind. Die andere würde die Anreize formen, die das Modell bei seiner Arbeit leiten.
Beide müssten validiert werden. Mein Ziel ist es, die Abhängigkeit von Menschen zu verringern, die Transkripte lesen und das System im Nachhinein korrigieren. Aber diese Interventionen zu beschreiben, beweist noch nicht, dass wir sie auch bauen können.
Was ich denke
Eine ähnliche Sorge hatte ich, als ich über Chat Control schrieb: Wie sehr darf ein Schutzmechanismus davon abhängen, dass Menschen ihn dauerhaft durchsetzen?
Aufgestellte Regeln überleben den Kontakt mit Menschen nicht. Nicht weil Menschen böse sind, sondern weil Regeln ständige Durchsetzung durch Menschen erfordern, die müde werden, sich bestechen lassen, ersetzt werden, überstimmt werden und das Interesse verlieren. Die Überwachungsseite muss nur ein einziges Mal gewinnen. Die Seite der Compute-Pause muss jedes einzelne Jahr bis 2040 gewinnen.
Was es also zu bauen lohnt, ist etwas, bei dem sich niemand immer wieder aufs Neue dafür entscheiden muss. Massenüberwachung architektonisch unmöglich machen statt illegal – genau das versuche ich mit ØCLOAK auszuloten. Einseitige Compute-Akkumulation strukturell unmöglich machen statt per Vertrag zu verbieten. Den Herstellungsprozess selbst so gestalten, dass man ein bestimmtes Trainingslimit nicht ohne die Zustimmung mehrerer anderer Parteien überschreiten kann, weil diese Zustimmung eine physische Abhängigkeit ist und keine bloße Unterschrift.
Ich habe diesen Entwurf nicht, und vielleicht ist er unmöglich. Ich möchte es untersuchen, weil die Aufrechterhaltung eines internationalen Abkommens über fünfzehn Jahre hinweg ebenfalls von einer kontinuierlichen Durchsetzung über Regierungswechsel, Personalwechsel und veränderte Anreize hinweg abhängt.
Was ich außerdem sagen will – und auch da kann ich mich irren: Ich glaube, dass Plan B das ist, was tatsächlich passieren wird. Wir kämpfen gegen China, oder wir verbringen ein Jahrzehnt damit, uns darauf vorzubereiten. Ich schlage mich da auf keine Seite. Ich vertraue den Tech-Oligarchen, die das in den USA vorantreiben, nicht im Geringsten, ich vertraue Peking genauso wenig, und es gibt Tage, an denen ich denke, dass China die Sache vielleicht besser hinbekommt – ein Satz, den man nur mit Unbehagen tippt.
Ich möchte nicht, dass die Kontrolle über so viel Compute und Wohlstand in wenigen Händen konzentriert ist. Ich wünsche mir Schutzmechanismen, die jeden einschränken, der an der Macht ist, einschließlich Grenzen, die die Machthabenden nicht eigenmächtig aufheben können. Dieselbe Macht einer KI zu übertragen, würde diese Sorge keineswegs zerstreuen.
Der erste Verhandlungsmeilenstein ist 2029. Bis dahin hätte ich gerne klarere Antworten darauf, wie das Abkommen mit Softwareverbesserungen umgeht, ab wann eine Offenlegung verpflichtend wird und was passiert, wenn die Verifikationstools noch nicht bereit sind.
~ A.