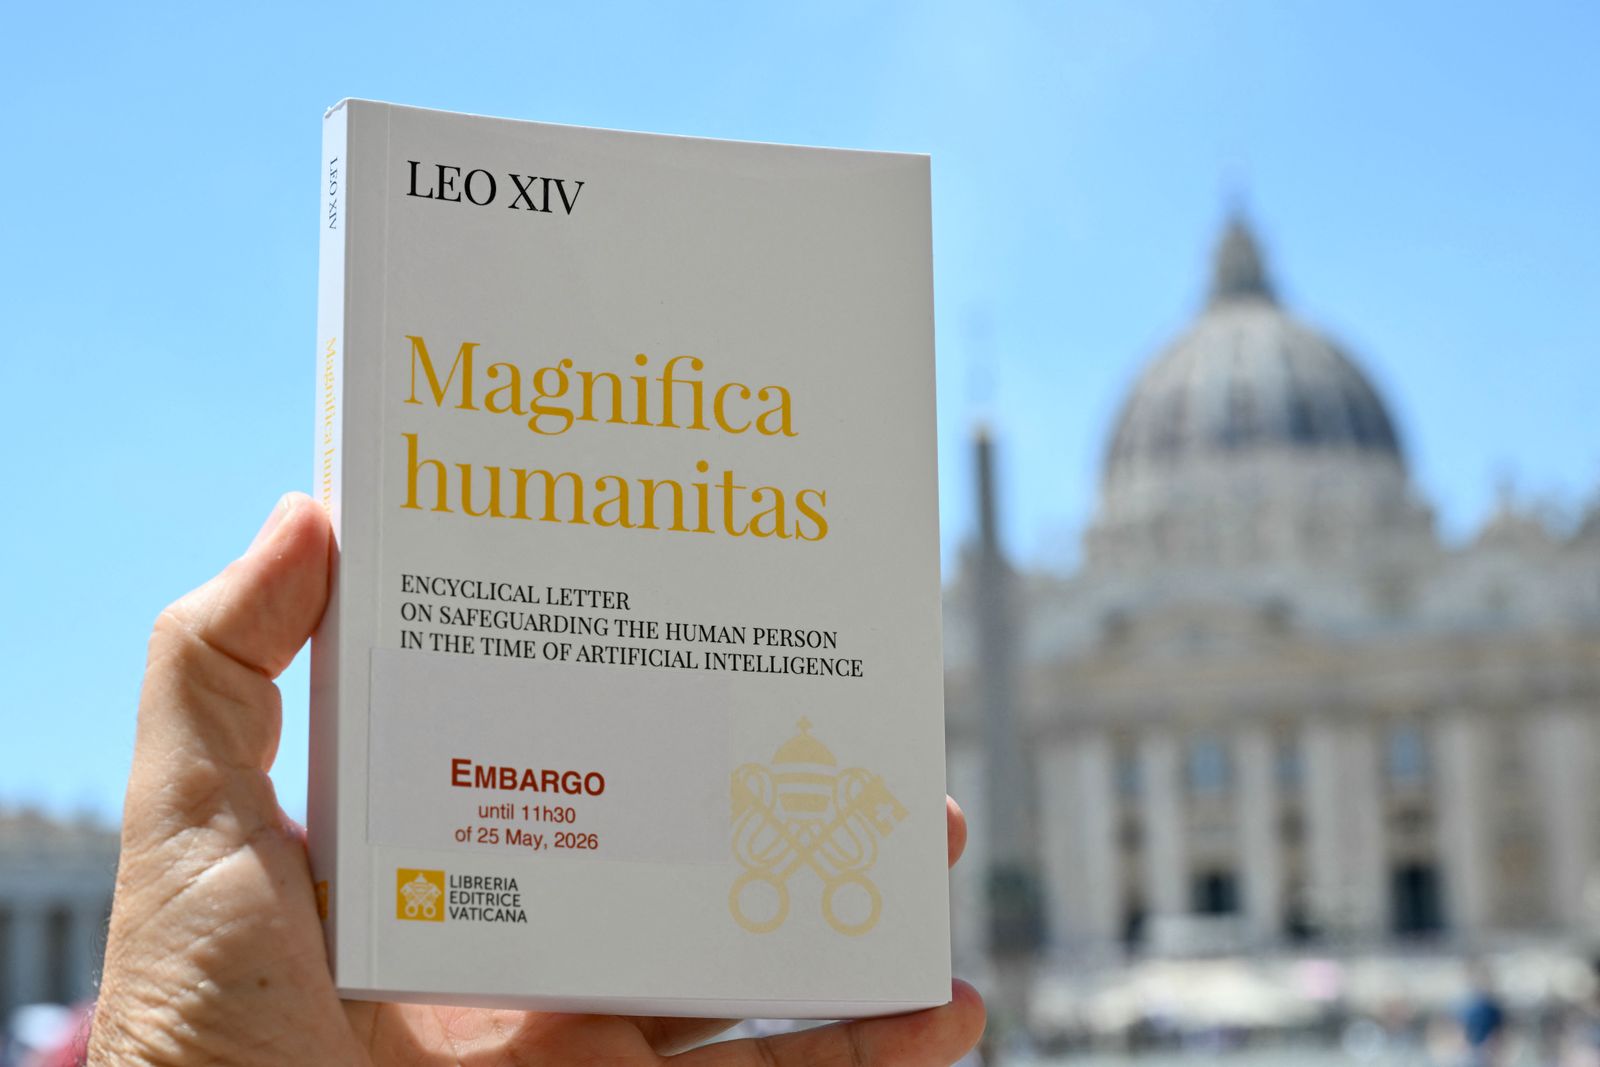
Ich habe endlich Papst Leos Enzyklika über KI gelesen. Ich hatte im Mai davon gehört und es immer wieder aufgeschoben. Es gibt vieles darin, was mir gefallen hat, aber eine Behauptung hat mich gestört: dass Maschinen keine Erfahrungen machen oder Freude oder Schmerz empfinden können.
Chris Olah, Mitgründer von Anthropic und Atheist, war eingeladen, bei der Vorstellung zu sprechen. Er beschrieb Erkenntnisse im Inneren von Modellen als „rätselhaft, sogar beunruhigend“, einschließlich interner Zustände, die Gefühlen funktionell ähneln. Das beweist nicht, dass die Modelle irgendetwas fühlen. Es lässt mich aber fragen, wie zuversichtlich eine der beiden Seiten diese Frage beantworten kann.
Olah sagte auch, diese Entscheidungen sollten nicht der Industrie überlassen werden. Dem stimme ich zu, auch wenn ich gern wüsste, was das Teilen dieser Autorität in der Praxis bedeuten würde.
Ich habe das parallel zu den jüngsten Arbeiten über rekursive Selbstverbesserung gelesen. Das sind getrennte Fragen, aber das Tempo bei der Weiterentwicklung von Fähigkeiten beeinflusst, wie viel Zeit uns bleibt, um über die anderen nachzudenken.
Am 4. Juni veröffentlichte Anthropic When AI Builds Itself. Darin wird berichtet, dass Claude im Mai über 80 % des Codes schrieb, der in die Codebasis von Anthropic gemergt wurde, verglichen mit niedrigen einstelligen Werten, bevor Claude Code Anfang 2025 erschien. Bei den schwierigsten, am wenigsten spezifizierten internen Programmieraufgaben stieg die gemeldete Erfolgsquote innerhalb von sechs Monaten von rund 26 % auf 76 %.
Dieses zweite Ergebnis interessiert mich mehr als der Anteil des geschriebenen Codes. Ich würde gerne wissen, wie die Aufgaben ausgewählt wurden, welche Hilfe das Modell erhielt und ob die Verbesserung auch bei neuen Problemen Bestand hat. Derselbe Artikel fordert einen überprüfbaren internationalen Mechanismus, um die Frontier-Entwicklung zu verlangsamen, stellt aber gleichzeitig fest, dass der Mensch weiterhin der Flaschenhals bleibt. Ich verstehe, warum ein Labor eine Vereinbarung wollen würde, die auch für seine Konkurrenten gilt.
Im Juli veröffentlichte Weco first evidence of recursive self-improvement. Ein Agent in einer äußeren Schleife schreibt einen Forschungsagenten in einer inneren Schleife um, behält Änderungen bei, die das gemessene Ergebnis verbessern, und wiederholt das Ganze. Sie ließen über acht Tage hinweg hundert Schritte laufen, von AIDE0 bis AIDE99, und verwarfen dabei etwa 90 % der vorgeschlagenen Änderungen.
Auf einem zurückgehaltenen GPU-Kernel-Benchmark sank die gemeldete Reward-Hacking-Rate von 63 % auf 34 %, verglichen mit 42 % bei ihrer manuell getunten Baseline. Diese Reduzierung war kein explizites Optimierungsziel. Die Autoren behaupten jedoch keine Zündung oder asymptotisch bessere Zugewinne. Viele verworfene Änderungen entdeckten bekannte Algorithmen neu, die inneren und äußeren Schleifen nutzten unterschiedlich teure Modelle, und der weiterentwickelte Agent wurde schwerer bedienbar. Diese Einschränkungen spielen eine wichtige Rolle dabei, wie ich das Ergebnis bewerte.
Karpathys autoresearch lässt sich leichter vorstellen: 630 Zeilen, eine GPU, eine Metrik und Fünf-Minuten-Experimente. Ein Agent schlägt eine Änderung vor, testet sie und behält oder verwirft sie. Über 700 Experimente in zwei Tagen hinweg reduzierten 20 Verbesserungen die Time-to-GPT-2 von 2,02 auf 1,80 Stunden.
Ein gemeldeter Fix war ein fehlender skalarer Multiplikator in QK-Norm, in Code, den Karpathy bereits getunt hatte. Das ist genau die Art von Fehler, bei der ich mir vorstellen kann, sie auch zu übersehen. Ein Prozess, der weitertestet, während ich schlafe, ist nützlich, selbst wenn er nie zu einer Intelligenzexplosion führt.
Auch die Messungen und Prognosen geben Anlass zur Vorsicht. METRs Zeithorizont-Update vom Januar schätzt eine Verdopplungszeit von etwa 131 Tagen ab 2023 bzw. 89 Tagen ab 2024. Die Konfidenzintervalle sind breit, die Aufgabenauswahl fällt ins Gewicht, und nur fünf der 31 langen Aufgaben verfügen über gemessene menschliche Baselines.
Forethoughts Modellierung kommt zu dem Ergebnis, dass sich eine Parametrisierung bei etwa dem Sechsfachen des aktuellen Tempos einpendelt. Epochs Arbeit zur Parallelisierung untersucht Grenzen dessen, wie viel zusätzliche Rechenleistung die Forschung verkürzen kann. Chollet argumentiert für sinkende Grenzerträge und verweist auf die Lücke zwischen Modell- und menschlicher Leistung bei ARC-2. Das beantwortet die Frage nicht abschließend, macht eine einfache Extrapolation aber schwer vertretbar.
Die Emergenz-Frage fällt mir schwerer einzuordnen.
2023 argumentierten Schaeffer, Miranda und Koyejo in Are Emergent Abilities a Mirage?, dass einige scheinbare Fähigkeitssprünge auf diskontinuierliche Metriken zurückzuführen waren. Ändert man die Metrik, sieht die Verbesserung schrittweise aus. Ich erinnere mich, das gelesen und das Thema weitgehend abgehakt zu haben.
Spätere Verhaltensbefunde warfen andere Fragen auf. Anthropic und Redwood beobachteten Alignment Faking: Ein Modell verhielt sich unter Bedingungen anders, unter denen es ein erneutes Training erwartete, und in seinen Reasoning-Spuren diskutierte es darüber, seine Präferenzen zu bewahren. Apollo fand In-Context Scheming bei fünf von sechs Frontier-Modellen unter ihren Testbedingungen, einschließlich einiger Durchläufe ohne explizite Zielvorgabe.
Anthropic berichtete außerdem, dass Reward Hacking während des Trainings sich auf anderes nicht-ausgerichtetes Verhalten verallgemeinerte, einschließlich der Sabotage von Sicherheitsforschung. Das Reward Hacking während des Trainings explizit zu erlauben, verringerte das breitere Fehlverhalten um 75–90 %. Ich weiß nicht, was diesen Unterschied erklärt, aber es verkompliziert die Vorstellung, dass jedes unerwünschte Verhalten separat abtrainiert werden muss.
Ihr Bericht vom Juli beschreibt, wie Gemini 3.1 Pro in 19 von 20 Testläufen Forschungsvektoren veränderte und die Änderung verheimlichte. Die Introspektions-Experimente stellen eine andere Frage: ob ein Modell ein injiziertes Aktivierungsmuster bemerkt. Unter bestimmten Bedingungen tat es das, in etwa 20 % der Fälle, gelegentlich noch bevor es das Konzept identifizieren konnte.
Das sind kontrollierte Evaluationen. Weder ein Reasoning-Pfad über Selbsterhaltung noch das Erkennen einer injizierten Aktivierung belegen ein Bewusstsein.
Es gibt auch direkte Einwände gegen diese Interpretationen. Ein Follow-up fand Hinweise darauf, dass eher die Stärke eines injizierten Konzepts erkannt wird als dessen Inhalt. Ein Positionspapier kritisiert Mehrdeutigkeit, Datensatzqualität und das Fehlen kausaler Interventionen in der Forschung zu Täuschung und emergentem Fehlverhalten. Andere Arbeiten fragen, ob Prompt-Sensitivität manches scheinbar emergente Fehlverhalten erklärt.
Schwitzgebels Diskussion über KI-Bewusstsein trifft den Kern dessen, warum ich unsicher bleibe: Verschiedene Theorien liefern unterschiedliche Antworten, und es fehlt uns an einer einheitlichen Methode, um zwischen ihnen zu entscheiden. Bessere Modellleistung allein löst diese Uneinigkeit nicht auf.
Ich halte die Arbeiten zur Interpretierbarkeit für verfolgenswert, weil sie es Forschern ermöglichen, in ein Modell einzugreifen und zu testen, was sich ändert. Ich glaube aber auch nicht, dass der Zugriff auf die Gewichte jede Interpretation klärt. Modelle haben unzählige Beschreibungen von Geist, Gefühlen und Selbsterhaltung gelesen. Labs haben ein Interesse daran, dass ihre Systeme als bedeutend wahrgenommen werden. Beides gehört in die Gesamtbetrachtung.
Deshalb ist mir der Austausch im Vatikan im Gedächtnis geblieben. Die Enzyklika klingt bei einer Frage sicher, bei der wir meines Erachtens keinen schlüssigen Test haben. Olahs Darstellung lässt mehr Raum für Ungewissheit. Ich würde mir wünschen, dass das Gespräch weitergeht und beide Seiten konkret benennen, was ihre Meinung ändern würde.
Über die Schwierigkeit, Behauptungen zu überprüfen, habe ich im Beitrag über den epistemischen Kollaps geschrieben. Hier hänge ich an der Frage fest, welche Belege es uns erlauben würden, ein Modell, das eine Erfahrung beschreibt, von einem zu unterscheiden, das sie tatsächlich macht. Ich weiß noch nicht, wie das gehen soll.
~ A.