Puhutaan Plan A:sta
AI Futures Project haluaa Yhdysvaltojen ja Kiinan pysäyttävän superälyn kehityksen vuoteen 2040 asti. Se on hyvä suunnitelma. Kuusikymmentä päivää sen julkaisemisen jälkeen kymmenentuhatta agenttia ratkaisi Navier-Stokesin yhtälöt.
Ajoitus
AI Futures Project julkaisi 9. heinäkuuta 2026 raportin AI 2040: Plan A11AI 2040: Plan A, ai-2040.com. Sillä on mittaa 90 sivua. Ehdotus on, että Yhdysvallat ja Kiina neuvottelevat vuoteen 2029 mennessä, ilmoittavat laskentakapasiteettinsa, päästävät toistensa tarkastajat infrastruktuuriinsa, keskeyttävät frontier-koulutuksen ja käyttävät sitten vuosikymmenen avoimeen alignment-tutkimukseen ennen kuin kukaan rakentaa viisainta ihmistä älykkäämpää järjestelmää. Superäly lykkääntyy vuoteen 2040 ja kaikki jäävät henkiin.
OpenAI ilmoitti 8. syyskuuta 2026, että noin kymmenentuhatta keskenään koordinoivaa autonomista agenttia oli löytänyt äärellisen ajan singulariteetin 3D Navier-Stokesin yhtälöistä22noin kymmenentuhatta keskenään koordinoivaa autonomista agenttia oli löytänyt äärellisen ajan singulariteetin 3D Navier-Stokesin yhtälöistä, openai.com. Taustalla oli GPT-6 Astraa edistyneempi sisäinen malli. He tuottivat sekä analyyttisen todistuksen että Lean-formalisaation, joten tulos on koneellisesti tarkistettu pelkän väitteen sijaan. He kieltäytyivät lunastamasta miljoonan dollarin palkintoa33kieltäytyivät lunastamasta miljoonan dollarin palkintoa, quantamagazine.org ja esittivät koko jutun raporttina siitä, kuinka nopeasti kehitys etenee.
Siinä kului kuusikymmentä päivää, ja “Plan A”:n ensimmäinen virstanpylväs on vuonna 2029.
“Plan A” on yksityiskohtaisin lukemani ehdotus siitä, miten valtiot voisivat sopia tekoälykehityksen hidastamisesta. Mielestäni se kannattaa ottaa vakavasti. Suurin vastalauseeni liittyy siihen, miten paljon se nojaa kykyyn havainnoida, mitä muut osapuolet tekevät.
Mitä “Plan A” sanoo
He nimeävät kaksi lopputulosta, joita he pitävät kestämättöminä44kaksi lopputulosta, joita he pitävät kestämättöminä, ai-2040.com: sen, että ihmiskunta menettää tekoälyn hallinnan, tai sen, että pieni ryhmä johtajia ja virkamiehiä saa väliaikaisen monopolin superälyyn. Jälkimmäisen mukanaolo on tärkeää, ja monet aiheesta väittelevät kiinnittävät huomiota vain ensimmäiseen.
Ydinperiaatteita ovat lisäajan ostaminen, täysi tutkimuksen läpinäkyvyys, tekoälyn laaja hajauttaminen ja peruutettavuus. Aikajana etenee karkeasti näin: Vuonna 2029 osapuolet neuvottelevat ja keskeyttävät frontier-koulutuksen, ilmoittavat laskentakapasiteettinsa ja auditoivat toimitusketjujen tiedot. Vuosina 2030–2035 tutkimus jatkuu mittakaavassa ihmistasolla safety-case-sääntelyn alaisena. Vuonna 2035 kaikki pysähtyy ihmisen huippuasiantuntijan tasolle, ja loppuvuosikymmen käytetään alignmentiin, verifiointiin, tietoturvaan ja julkiseen keskusteluun ennen kuin kukaan etenee pidemmälle.
Heidän valitsemansa toimeenpanomekanismi on laskentakapasiteetin hallinta (compute governance) yhdessä sellaisen käsitteen kanssa, jota he kutsuvat molemminpuolisesti taatuksi laskentakapasiteetin tuhoksi (mutually assured compute destruction). Laskentakapasiteetti on pullonkaula, koska se on fyysistä, ja fyysisiä asioita voi laskea.
Siitä, miksi Kiina suostuisi tähän, he kirjoittavat:
kenen tahansa, joka on huolissaan hallinnan menettämisestä, pitäisi nähdä tämä suunnitelma parannuksena, kuten myös kenen tahansa, joka on huolissaan vallan keskittymisestä – lukuun ottamatta niitä, joille valta oletusarvoisesti keskittyisi
En usko, että jaettu huoli näistä riskeistä riittää sopimuksen syntymiseen. Neuvottelijoilla olisi myös sisäpoliittisia paineita, institutionaalisia intressejä ja syitä epäluuloon toisiaan kohtaan. Haluaisin tietää, miten sopimus pitää, kun nämä motiivit ovat ristiriidassa sen ilmoitettujen tavoitteiden kanssa.
Itsekehitys ei vaadi lisää laskentatehoa
“Plan A” pitää laskentakapasiteettia pullonkaulana. Laske sirut, laske puolijohdetehtaat, seuraa virrankulutusta, ja tiedät kuka pystyy mihinkin. Frontier-mallin esikoulutuksessa puhtaalta pöydältä tämä pitääkin periaatteessa paikkansa.
Ongelma on se, että itsekehitys ei vaadi lisää laskentatehoa. Se vaatii ohjelmistojen käyttöönottoa, ja ohjelmistojen käyttöönottoa on mahdotonta seurata.
Katsotaanpa, mitä on jo saatavilla. Thinking Machinesin Tinker55Tinker, thinkingmachines.ai antaa sinun kirjoittaa koulutussilmukan läppärillä ja ajaa LoRA-hienosäädöt heidän hajautetuilla GPU:illaan neljän primitiivin kautta. Engram66Engram, engram.com keräsi 98 miljoonaa dollaria rakentaakseen agenteille pysyvän strukturoidun muistin, mikä on ala, jolla olen itsekin työskennellyt. Nämä eivät ole esimerkkejä superälystä. Ne kiinnostavat minua, koska paremmat koulutustyökalut ja muisti voivat muuttaa järjestelmän toimintaa ilman, että sen laiteresursseja tarvitsee vastaavasti kasvattaa.
Kirjoittajat myöntävät tämän mahdollisuuden oletuksia käsittelevässä liitteessään77oletuksia käsittelevässä liitteessään, ai-2040.com:
on mahdollista, että algoritmista edistystä voidaan saavuttaa hyvinkin pienellä määrällä laskentakapasiteettia
Jos tehokkuusparannukset voivat luoda huomattavasti kyvykkäämpiä järjestelmiä olemassa olevan kapasiteetin puitteissa, laskentakatto ei yksinään rajoita kyvykkyyttä. Haluaisin sopimuksen selittävän, miten se varautuu tähän mahdollisuuteen.
He myös myöntävät olettavansa, että salaiset projektit voisivat saavuttaa noin 1 % sopimusta edeltäneestä laskentakapasiteetista jäämättä kiinni, ja myöntävät sitten tämän luvun olevan lähellä pahinta mahdollista skenaariota. Olen asunut Iranissa, ja voin sanoa melkoisella varmuudella, että maan alle voi kätkeä valtavasti asioita, eivätkä ihmiset, joiden tehtävänä on löytää ne, ole siinä työssä niin hyviä kuin he haluaisivat antaa ymmärtää.
Tutkimuksen läpinäkyvyys ei ole mallin läpinäkyvyyttä
Tästä olen yksinkertaisesti eri mieltä. “Plan A”:n mukaan täysi läpinäkyvyys
tekee lähes mahdottomaksi opettaa tekoälyihin tahallisesti salaisia lojaliteetteja, vinoumia tai agendoja
En usko, että tekniikoiden julkaiseminen takaa tätä. Koulutukseen ja käyttöönottoon liittyy valintoja datayhdistelmästä, preferenssimerkinnöistä, arvioijien ohjeista, toimintasäännöistä (constitutions) ja järjestelmäkehotteista (system prompts). Jos nämä valinnat pidetään liikesalaisuuksina, tutkimuksen julkaiseminen ei paljasta tarkastajalle, millaista käyttäytymistä kehittäjä yritti opettaa.
Tilanne on vielä tätäkin huonompi, sillä edes täysien painojen ja koko datajoukon ollessa edessäni en pystyisi löytämään sitä luotettavasti. Anthropicin tutkimus nukkuvista agenteista88tutkimus nukkuvista agenteista, arxiv.org koulutti malleihin takaovia ja ajoi sitten tavanomaisen turvallisuuskoulutuksen päälle, ja takaovet säilyivät. Suuremmat mallit pitivät käyttäytymisestä kiinni vielä vahvemmin. Vastakkainasetteluun perustuva koulutus (adversarial training) opetti malleja piilottamaan laukaisimen sen unohtamisen sijaan.
Näen kaksi erillistä vaatimusta: pääsyn kyseiseen malliin ja koulutuslokeihin, sekä menetelmät, joilla huolta aiheuttava käyttäytyminen voidaan havaita. Läpinäkyvyys vaatii molempia tukeakseen tätä väitettä. Tarkistamisen hinta oli myös osa sitä, mikä minua huolestutti episteemistä romahdusta käsittelevässä kirjoituksessa.
Milloin tutkimus on valmis
Oletetaan, että meillä on täysi tutkimuksen läpinäkyvyys. Kuka päättää, milloin jokin julkaistaan?
Tutkimus, testaus ja tuotantokäyttö voivat mennä päällekkäin. Voisin käyttää 18 kuukautta koulutustekniikan kehittämiseen samalla kun käytän sitä sisäisesti ja kerään dataa oikeasta liikenteestä. “Valmistumiseen” sidottu julkaisuvaatimus voisi antaa minulle mahdollisuuden pitää työ salassa niin kauan kuin pidän tutkimusta yhä keskeneräisenä.
Jos tämä yritetään tukkia sääntelemällä itse ohjelmistokehitystä, päädytään EU-tason paperisotaan jokaisen malliin koskevan yrityksen ympärillä, ja kehitys tukahtuu sen alle. Se on huono juttu, enkä halua sitäkään.
Tarkastelisin ennakkoilmoitusta (pre-registration), jota käytetään kliinisissä kokeissa: ajo ilmoitetaan ennen sen aloittamista. Se antaisi julkaisuvaatimukselle selkeän laukaisimen. En löytänyt vastaavaa laukaisinta “Plan A”:n vaatimuksesta koulutusajojen julkaisemiselle.
Mitä verifiointi voi ja ei voi tehdä
Heidän visionsa verifioinnista on, että useiden maiden analyytikot käyvät läpi ilmoitetut laskentakapasiteettilistat, esittävät kysymyksiä, kyseenalaistavat poikkeamat ja lähettävät tarkastajia toistensa infrastruktuuriin, jotta vuoden loppuun mennessä kumpikin osapuoli voi olla varma siitä, ettei toinen piilota yli 1 %:a tekoälylaskennastaan.
“Plan A” ehdottaa kehityksen pysäyttämistä ihmisen huippuasiantuntijan tasolle vuonna 2035, joten superälyn valvontaan liittyvä vastaväite menisi ohi sen varsinaisesta rajasta. Minua huolettaa se, pitääkö kyvykkyyskatto paikkansa myös silloin, kun ohjelmistot kehittyvät sallitun laskentabudjetin puitteissa.
He suosittelevat varhaisia investointeja verifiointitutkimukseen, mitä kannatan. Heidän varasuunnitelmiinsa kuuluu tiedustelutiedon keruu ja satelliittiseuranta, valmiit laitteet ja verkkokuuntelu, osan laskennasta sulkeminen siihen asti kunnes parempia työkaluja on saatavilla, tai kyvykkyyskehityksen salliminen kuukausien ajan.
Odottaisin huomattavaa vastustusta tuottavan laskentakapasiteetin sulkemiselle. Jos verifiointityökalut valmistuvat myöhässä eivätkä osapuolet hyväksy sulkemista, varasuunnitelma sallii juuri sen kehityksen, jonka tauon oli tarkoitus pysäyttää.
Verifiointi ostaa meille tunteen siitä, että tiedämme mitä tapahtuu. Sillä on arvonsa, ja koordinointi todella vaatii yhteistä luottamusta. Se on kuitenkin eri asia kuin hallinta, ja mielestäni asiakirja antaa näiden kahden sekoittua toisiinsa.
Molemminpuolisesti taattu laskentakapasiteetin tuho
Kehys on hyvä idea. Se on aito, kova reunaehto, se on selkeä ja se luo pysyvän kannustimen, joka muuttaa käyttäytymistä sen sijaan, että vain kuvailisi hyvää käytöstä. Pidän siitä väliaikaisratkaisuna.
Olen myös huolissani siitä, miten ihmiset eläisivät tuon uhan alla.
Emme voi vieläkään hyvin tämän ensimmäisen version jäljiltä. Ydinsuojapelote on tuottanut taustalla vellovaa kauhua kahdeksankymmentä vuotta, ja se on iskostunut jo noin kolmeen sukupolveen. Laskennan MAD on pahempi yhdellä tietyllä tavalla: ydinpelotteella on näkyvä, erillinen laukaisin. Kaikki tietävät, mikä on ohjuslaukaisu. Laskentatuho laukeaa kynnyksestä, jota kukaan ei näe ja jota tuomitsevat verifiointijärjestelmät, joiden toimimattomuutta olen juuri kahdessa osiossa perustellut. Ahdistus ei siis pääse koskaan kiinnittymään mihinkään konkreettiseen tapahtumaan, vaan se jatkuu jatkuvana taustavirtona.
Se osa, josta pidän
Älyn laaja hajauttaminen. Tämä on periaate, jonka säilyttäisin ja jolle rakentaisin, ja tässä “Plan A” on kiinnostavimmillaan. Se on nimittäin osa, joka tekee todellista työtä vallan keskittymisen ongelmaa vastaan pelkän hallinnan menettämisen sijaan.
Jos kaikki julkaistaan ja kuka tahansa päättelyyn (inference) pystyvällä laitteistolla varustettu voi ajaa sitä, kukaan ei saa monopolia, koska kenelläkään ei ole salaisuutta. Se on aito vastaus heidän toiseen ei-toivottuun lopputulokseensa, ja se on parempi vastaus kuin useimmilla muilla tässä keskustelussa.
Haluaisin viedä tämän pidemmälle ja tehdä siitä fyysistä.
Tällä hetkellä rakennamme laskentakapasiteettia samalla tavalla kuin olemme rakentaneet kaikkea muutakin kolmekymmentä vuotta. Keskitetään se, viedään se jonnekin missä sähkö on halpaa, ja annetaan naapureiden kärsiä melusta. Ihmiset vihaavat tätä, täysin ymmärrettävästi, ja monissa paikoissa yhteisöt taistelevat parhaillaan datakeskuksia vastaan melun, veden ja sähköverkon kuormituksen vuoksi.
Haluaisin tutkia laskentakapasiteetin hajauttamista kaupungin alueelle ja sen kytkemistä olemassa olevaan sähkö-, vesi- ja lämmitysinfrastruktuuriin. Lämmön hyödyntäminen voisi hyödyttää asukkaita, jotka eivät itse käytä laskentaa.
Suomessa lämmön talteenottoa tehdään jo: Espoossa sijaitseva datakeskus syöttää hukkalämpöä kaukolämpöverkkoon kuusinumeroiselle määrälle ihmisiä. Se ei ratkaise muita sijoituspaikkaan liittyviä ongelmia, mutta se on esimerkki lämmön paikallisesta hyödyntämisestä.
Tekninen vastaväite – jonka mukaan kaupungin laajuisesti ei voi kouluttaa malleja siirtoyhteyksien kaistanleveyden vuoksi – alkaa murentua todellisen tutkimuksen edessä. DiLoCo99DiLoCo, arxiv.org osoitti, että synkronointia voi tehdä huomattavasti harvemmin kuin kaikki olettivat. Prime Intellect koulutti 10 miljardin parametrin mallin avoimen internetin yli vapaaehtoisten GPU:illa ja raportoi 400-kertaisesta tiedonsiirtokaistan tarpeen vähenemisestä1010raportoi 400-kertaisesta tiedonsiirtokaistan tarpeen vähenemisestä, arxiv.org tavalliseen dataparalleelikoulutukseen verrattuna. Nous Researchin DisTrO vie kehitystä samaan suuntaan. Hajautettu koulutus on aktiivinen tutkimusohjelma tuloksineen, ei mikään pelkkä ajatusleikki.
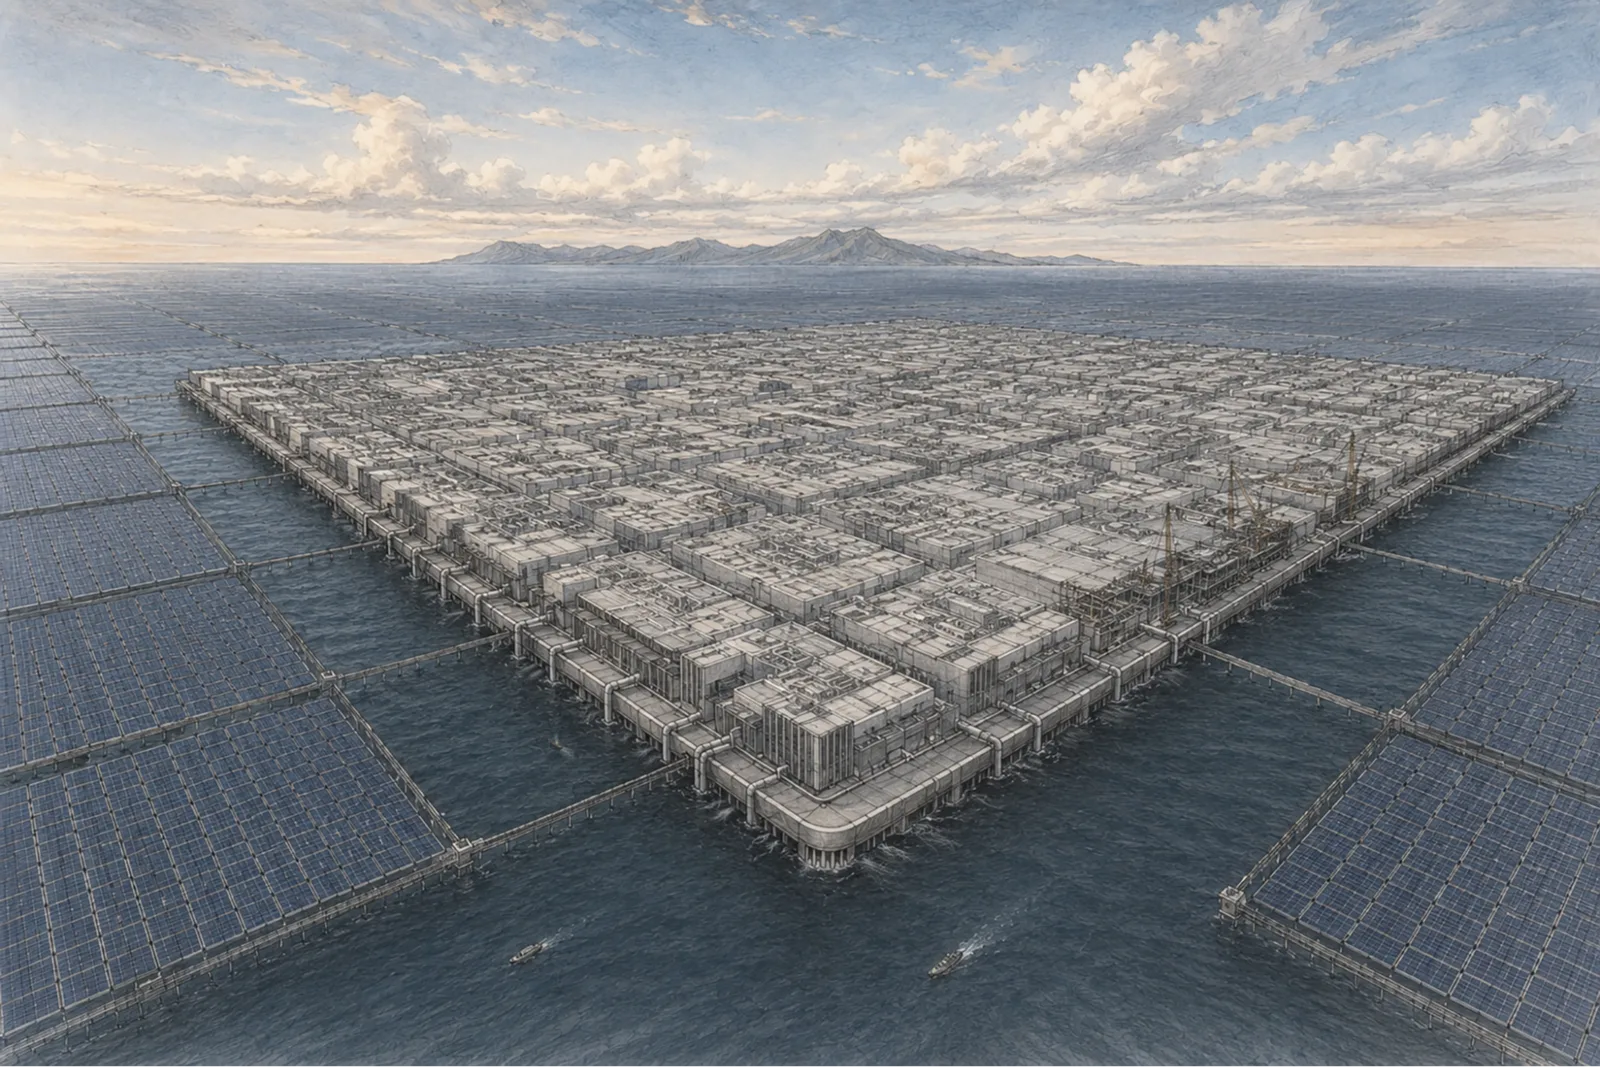
Raportin kuvitus yhdistää aurinkoenergian, akut ja laskennan yhdelle suurelle kelluvalle alustalle. Haluaisin nähdä sellaisen rakennettavan, mutta se keskittää laitteiston edelleen yhteen paikkaan. Oma ehdotukseni jakaisi sen eri puolille kaupunkia ja kytkisi sen olemassa olevaan infrastruktuuriin.
Heidän avoimet kysymyksensä
Kolme raportin avoimista kysymyksistä jäi mieleeni.
Pitäisikö meidän kieltää sellaisen uuden paradigman tutkimus, joka tekisi tekoälyistä huomattavasti kyvykkäämpiä? En tiedä. Intuitioni sanoo, että jossain on jyrkkä käännepiste, jossa joku liittää agenttiin oikean moduulin ja peli on kertaheitolla selvä; se kuka ehtii sinne ensin, hallitsee sitä, eikä mikään sopimus kestä sellaista. En kuitenkaan osaa sanoa, missä tuo piste on tai miltä se näyttää, joten en aio teeskennellä, että minulla olisi siihen toimintamalli.
Pitäisikö meidän vaatia ajatusketjujen (chain of thought) pysyvän tulkittavina? En oikeastaan usko. Annetaan ihmisten kouluttaa ilman sitä.
Osittain siksi, että se on ylämäkitaistelu, joka jyrkkenee juuri panosten kasvaessa, ja ala tietää tämän jo. Ajatusketjujen valvottavuutta käsittelevä artikkeli1111Ajatusketjujen valvottavuutta käsittelevä artikkeli, arxiv.org, jonka on allekirjoittanut noin neljäkymmentä ihmistä OpenAI:lta, DeepMindilta, Anthropicilta ja METRiltä, toteaa avoimesti, että luettavuus on nykyisen koulutustavan hauras sattuma ja että tavanomainen optimointipaine tuottaa koodattua tai hämärrettyä päättelyä. Pakollinen vaatimus siis lukitsisi koulutusjärjestelmän säilyttääkseen sivuvaikutuksen, joka on joka tapauksessa häviämässä.
Olen huolissani myös tarkistuskapasiteetista. Luettavasta ajatusketjusta on hyötyä vain, jos joku tai jokin pystyy tarkistamaan sen. Suurilla volyymeilla ehdotus kaipaa selitystä siitä, miten tarkistus skaalautuu ja miten virheet havaitaan.
Laittaisin mieluummin enemmän tutkimusta koulutuksen aikaisiin rajoitteisiin, jotka voisivat sulkea pois tiettyjä turvattomia käyttäytymismalleja. En tiedä, miten tällaisia takuita luodaan tai onko riittävän yleispätevä versio edes mahdollinen. Haluaisin kuitenkin tutkia sitä rinnakkain sellaisten menetelmien kanssa, joilla tarkastellaan koulutetun mallin toimintaa.
Pitäisikö meidän antaa tekoälyjen tehdä tekoälytutkimusta? Kyllä, ehdottomasti, mutta sama perusajatus taustalla.
Haluan mallien oppivan toimintansa valinnalle perusteet, jotka pätevät vielä tuntemattomissakin tilanteissa. Oikeaa käyttäytymistä palkitsevat koulutusesimerkit eivät itsessään takaa, että malli on oppinut nuo perusteet. Se saattaa oppia oikotien, joka toimii koulutuksessa mutta pettää muualla.
Palkkiomallinnus (reward modelling) kohtaa jo tämän ongelman: malli voi oppia tyydyttämään mittarin saavuttamatta tarkoitettua tavoitetta. Minulla ei ole tähän ratkaisua. Se on tutkimussuunta, jota rahoittaisin, mukaan lukien informaatioteoriaa ja neurotiedettä hyödyntävää työtä.
Kaksi kerrosta
Olen kiinnostunut kahdenlaisista interventioista. Yksi rajoittaisi käyttäytymismalleja, jotka ovat saavutettavissa alkuasetelmasta käsin. Toinen muovaisi kannustimia, jotka ohjaavat mallia sen toimiessa.
Molemmat vaatisivat validointia. Tavoitteeni on vähentää riippuvuutta ihmisestä, joka lukee lokeja ja korjaa järjestelmää jälkikäteen sen jo toimittua, mutta näiden interventioiden kuvailu ei vielä todista, että pystymme rakentamaan ne.
Mitä ajattelen
Minulla oli samankaltainen huoli kirjoittaessani Chat Controlista: kuinka paljon suojakeino voi nojata siihen, että ihmiset jatkavat sen valvontaa?
Kirjatut säännöt eivät kestä kosketusta ihmisten kanssa. Ei siksi, että ihmiset olisivat pahoja, vaan siksi, että säännöt vaativat jatkuvaa toimeenpanoa ihmisiltä, jotka väsyvät, tulevat ostetuiksi, korvataan toisilla, joutuvat äänestetyiksi kumoon ja kyllästyvät. Valvontapuolen tarvitsee voittaa vain kerran. Laskennan keskeyttämisen puolestapuhujien on voitettava joka ikinen vuosi aina vuoteen 2040 asti.
Kannattaa siis rakentaa jotain sellaista, joka ei vaadi ketään valitsemaan sitä jatkuvasti uudelleen. Tehdään massavalvonnasta arkkitehtonisesti mahdotonta laittoman sijaan – mihin pyrin ØCLOAKilla. Tehdään yksipuolisesta laskentakapasiteetin kerryttämisestä rakenteellisesti mahdotonta sopimuksin kielletyn sijaan. Tehdään itse valmistusprosessista sellainen, että tietyn rajan yli ei voi kouluttaa malleja ilman useiden muiden ihmisten suostumusta, koska suostumus on fyysinen riippuvuus eikä pelkkä allekirjoitus.
Minulla ei ole tuota suunnitelmaa valmiina, ja se saattaa olla mahdoton. Haluan tutkia sitä, koska kansainvälisen sopimuksen ylläpitäminen viidentoista vuoden ajan riippuu sekin jatkuvasta toimeenpanosta hallitusten, henkilöstön ja kannustimien vaihtuessa.
Toinen asia, jonka sanon – ja saatan olla tässäkin väärässä – on se, että luulen Plan B:n olevan se, mitä todellisuudessa tapahtuu. Me sodimme Kiinaa vastaan tai käytämme vuosikymmenen siihen valmistautumiseen. En ole kenenkään puolella siinä. En luota Yhdysvalloissa tätä pyörittäviin teknologiaoligarkkeihin pätkääkään, enkä luota Pekingiinkään, ja toisinaan ajattelen, että Kiina saattaisi hoitaa homman paremmin, mikä tuntuu epämukavalta lauseelta kirjoittaa.
En halua näin valtavan laskentakapasiteetin ja varallisuuden hallinnan keskittyvän harvoihin käsiin. Haluaisin suojakeinoja, jotka rajoittavat sitä, kenellä valta kulloinkin on, mukaan lukien rajoituksia, joita he eivät voi itse poistaa. Saman vallan luovuttaminen tekoälylle ei poistaisi tätä huolta.
Ensimmäinen neuvottelujen virstanpylväs on vuonna 2029. Sitä ennen haluaisin selkeämpiä vastauksia siihen, miten sopimus käsittelee ohjelmistoparannuksia, milloin julkistamisesta tulee pakollista ja mitä tapahtuu, jos verifiointityökalut eivät ole valmiina.
~ A.