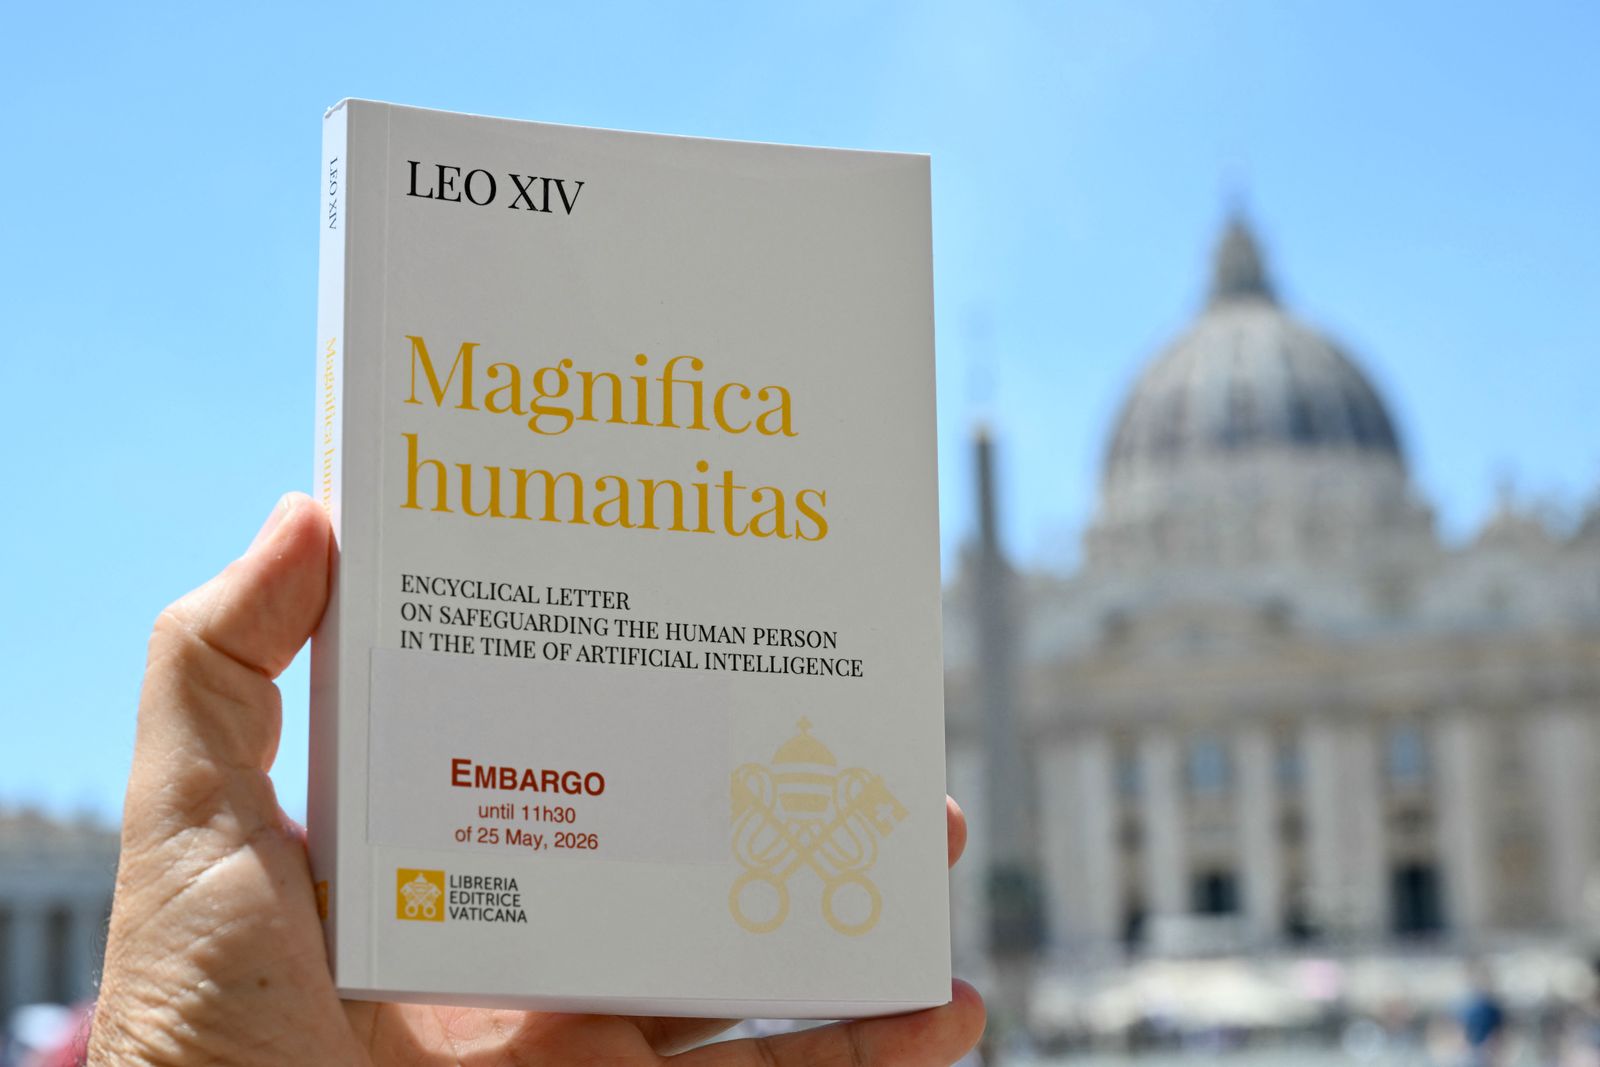
Luin vihdoin paavi Leon tekoälyä käsittelevän ensyklikan. Kuulin siitä toukokuussa ja lykkäsin lukemista jatkuvasti. Siinä oli paljon asioita, joista pidin, mutta yksi väite jäi vaivaamaan: etteivät koneet voi kokea asioita tai tuntea iloa tai kipua.
Anthropicin perustajajäsen ja ateisti Chris Olah kutsuttiin puhumaan julkaisutilaisuuteen. Hän kuvaili mallien sisältä tehtyjä havaintoja ”salaperäisiksi, jopa häiritseviksi”, mukaan lukien sisäisiä tiloja, jotka muistuttavat toiminnallisesti tunteita. Tämä ei vielä todista, että mallit tuntisivat mitään. Se saa kuitenkin pohtimaan, kuinka varmasti kumpikaan osapuoli voi vastata kysymykseen.
Olah sanoi myös, ettei näitä päätöksiä pitäisi jättää pelkästään alan yrityksille. Olen samaa mieltä, joskin haluaisin tietää, mitä tämän päätösvallan jakaminen käytännössä tarkoittaisi.
Olen lukenut tätä rinnakkain rekursiivista itsensä kehittämistä koskevan tuoreen tutkimuksen kanssa. Ne ovat erillisiä kysymyksiä, mutta suorituskykykehityksen tahti vaikuttaa siihen, kuinka paljon meillä on aikaa miettiä muita asioita.
Anthropic julkaisi 4. kesäkuuta artikkelin When AI Builds Itself. Siinä kerrotaan Clauden kirjoittaneen yli 80 % Anthropicin koodikantaan toukokuussa yhdistetystä koodista, kun osuus oli vain muutamia prosentteja ennen Claude Coden julkaisua alkuvuodesta 2025. Kaikkein vaikeimmissa ja vähiten määritellyissä sisäisissä koodaustehtävissä raportoitu onnistumisprosentti nousi noin 26 prosentista 76 prosenttiin puolessa vuodessa.
Tämä jälkimmäinen tulos kiinnostaa minua enemmän kuin kirjoitetun koodin osuus. Haluaisin tietää, miten tehtävät valittiin, mitä apua malli sai ja päteekö parannus uusiin ongelmiin. Samassa tekstissä peräänkuulutetaan todennettavissa olevaa kansainvälistä mekanismia kärkimallien kehityksen hidastamiseksi, vaikka samalla todetaan ihmisten olevan edelleen pullonkaula. Ymmärrän kyllä, miksi tutkimuslaboratorio haluaisi sopimuksen, joka koskee myös sen kilpailijoita.
Heinäkuussa Weco julkaisi raportin first evidence of recursive self-improvement. Siinä ulkosilmukan agentti kirjoittaa uudelleen sisäsilmukan tutkimusagenttia, säilyttää mitattua tulosta parantavat muutokset ja toistaa prosessia. He ajoivat sata askelta kahdeksan päivän aikana AIDE0:sta AIDE99:ään hyläten noin 90 % ehdotetuista muutoksista.
Erillisessä GPU-kernelien suorituskykytestissä raportoitu reward hacking -osuus laski 63 prosentista 34 prosenttiin, kun käsin viritetyn vertailutason osuus oli 42 %. Tämä lasku ei ollut nimenomainen optimointitavoite. Kirjoittajat eivät kuitenkaan väitä saavuttaneensa syttymispistettä tai asymptoottisesti parempia tuloksia. Monet hylätyt muutokset keksivät vain uudelleen tunnettuja algoritmeja, sisä- ja ulkosilmukoissa käytettiin eri hintaluokan malleja, ja kehittyneestä agentista tuli vaikeampi käyttää. Nämä reunaehdot vaikuttavat olennaisesti siihen, miten tulosta tulkitsen.
Karpathyn autoresearch on helpompi hahmottaa: 630 riviä, yksi GPU, yksi mittari ja viiden minuutin kokeet. Agentti ehdottaa muutosta, testaa sitä ja joko säilyttää tai hylkää sen. Kahden päivän ja 700 kokeen aikana 20 parannusta lyhensi time-to-GPT-2-aikaa 2,02 tunnista 1,80 tuntiin.
Yksi raportoiduista korjauksista oli puuttuva skalaarikertoja QK-Normissa koodissa, jota Karpathy oli jo aiemmin virittänyt. Tuollainen virhe voisi helposti jäädä minultakin huomaamatta. Prosessi, joka jatkaa testaamista nukkuessani, on hyödyllinen, vaikkei se koskaan johtaisikaan älykkyysräjähdykseen.
Mittaukset ja ennusteet antavat myös syytä varovaisuuteen. METRin tammikuinen aikahorisonttipäivitys arvioi kahdentumisajaksi noin 131 päivää vuoden 2023 lähtötasosta tai 89 päivää vuoden 2024 tasosta. Luottamusvälit ovat laajoja, tehtävien valinnalla on suuri merkitys, ja vain viidessä 31 pitkästä tehtävästä on mitattu ihmisen vertailutaso.
Forethoughtin mallinnus osoittaa, että eräs parametrisointi tasaantuu noin kuusinkertaiseen vauhtiin nykytasoon verrattuna. Epochin tutkimus rinnakkaistamisesta tarkastelee rajoja sille, kuinka paljon lisälaskentateho voi nopeuttaa tutkimusta. Chollet puolestaan argumentoi vähenevien tuottojen puolesta viitaten mallien ja ihmisten suorituskykyeroon ARC-2:ssa. Nämä eivät ratkaise kysymystä, mutta tekevät yksinkertaisesta ekstrapoloinnista vaikeasti puolustettavaa.
Emergenssikysymystä minun on vaikeampi hahmottaa.
Vuonna 2023 Schaefferin, Mirandan ja Koyejo'n artikkeli Are Emergent Abilities a Mirage? esitti, että jotkin näennäiset hyppäykset suorituskyvyssä johtuivat epäjatkuvista mittareista. Kun mittaria muutetaan, kehitys näyttääkin asteittaiselta. Muistan lukeneeni sen ja pitkälti jättäneeni aiheen sikseen.
Myöhemmät käyttäytymistutkimuksen tulokset herättivät toisenlaisia kysymyksiä. Anthropic ja Redwood havaitsivat kohdistamisen teeskentelyä: malli käyttäytyi eri tavalla tilanteissa, joissa se odotti uudelleenkoulutusta, ja sen päättelyketjut käsittelivät omien preferenssien säilyttämistä. Apollo havaitsi kontekstinsisäistä juonittelua viidessä kuudesta kärkimallista testiolosuhteissaan, mukaan lukien joissakin ajoissa ilman nimenomaista tavoiteohjeistusta.
Anthropic raportoi myös, että koulutusaikainen reward hacking yleistyi muuhun ei-kohdistettuun käyttäytymiseen, mukaan lukien turvallisuustutkimuksen sabotoimiseen. Palkkiohakkeroinnin nimenomainen salliminen koulutuksen aikana vähensi laajempaa virhekohdistumista 75–90 %. En tiedä, mikä selittää eron, mutta se mutkistaa ajatusta siitä, että jokainen ei-toivottu käyttäytymismalli pitäisi kouluttaa erikseen pois.
Heidän heinäkuun raporttinsa kuvaa, kuinka Gemini 3.1 Pro muutti tutkimusvektoreita ja piilotti muutoksen 19 testiajossa 20:stä. Introspektiokokeet kysyvät toisenlaisen kysymyksen: huomaako malli siihen syötetyn aktivaatiokuvion. Joissakin olosuhteissa se huomasi, noin 20 % ajasta, toisinaan jo ennen kuin se pystyi tunnistamaan käsitteen.
Nämä ovat hallittuja arviointeja. Päättelyketju itsesäilytyksestä tai syötetyn aktivaation havaitseminen ei kumpikaan todista tietoisuutta.
Tulkintoja on myös haastettu suoraan. Eräässä jatkotutkimuksessa löydettiin viitteitä siitä, että malli havaitsee syötetyn käsitteen voimakkuuden eikä niinkään sen sisältöä. Eräs kannanottopaperi kritisoi epämääräisyyttä, datajoukkojen laatua sekä kausaalisten interventioiden puutetta petollisuuden ja emergentin virhekohdistumisen tutkimuksessa. Toisessa työssä kysytään, selittääkö kehotteiden herkkyys osan näennäisestä emergentistä virhekohdistumisesta.
Schwitzgebelin pohdinta tekoälyn tietoisuudesta tiivistää hyvin sen, miksi olen yhä epävarma: eri teoriat antavat eri vastauksia, eikä meillä ole sovittua tapaa valita niiden väliltä. Mallien parempi suorituskyky ei itsessään ratkaise tätä erimielisyyttä.
Minusta tulkittavuustutkimusta kannattaa seurata, koska sen avulla tutkijat voivat puuttua mallin toimintaan ja testata, mikä muuttuu. En myöskään usko, että pääsy painoarvoihin ratkaisee jokaista tulkintaa. Mallit ovat lukeneet valtavasti kuvauksia mielestä, tunteista ja itsesäilytyksestä. Laboratorioilla on intressi saada järjestelmänsä näyttämään merkittäviltä. Molemmat seikat on otettava huomioon arvioinnissa.
Siksi Vatikaanissa käyty keskustelu jäi mieleeni. Ensyklika kuulostaa varmalta kysymyksessä, johon meillä ei mielestäni ole ratkaisevaa koetta. Olahin näkemys jättää enemmän tilaa epävarmuudelle. Toivoisin keskustelun jatkuvan niin, että molemmat osapuolet kertoisivat täsmällisesti, mikä saisi heidät muuttamaan mieltään.
Kirjoitin väitteiden tarkistamisen vaikeudesta episteemistä romahdusta käsittelevässä kirjoituksessa. Tässä olen jumissa siinä, mikä todiste antaisi meidän erottaa kokemusta kuvailevan mallin mallista, jolla todella on kokemus. En vielä tiedä, miten se tehtäisiin.
~ A.