Plan Aについて話そう
AI Futures Projectは、米中が超知能の開発を2040年まで一時停止することを望んでいる。優れた計画だ。彼らがそれを発表してから60日後、1万のエージェントがNavier-Stokes方程式を解いてしまった。
タイミング
2026年7月9日、AI Futures ProjectはAI 2040: Plan A11AI 2040: Plan A, ai-2040.comを発表した。90ページに及ぶ内容だ。その提案は、米中が2029年までに交渉を行い、保有する計算リソースを申告し、互いのインフラに査察官を受け入れ、フロンティアモデルのトレーニングを一時停止したうえで、最も賢い人間よりも賢い何かが構築される前に、全員で10年間オープンにアライメント研究を行うというものだ。超知能の登場は2040年まで先送りされ、全員が生き延びる。
2026年9月8日、OpenAIは約1万の自律エージェントが連携して3次元Navier-Stokes方程式の有限時間特異点を発見した22約1万の自律エージェントが連携して3次元Navier-Stokes方程式の有限時間特異点を発見した, openai.comと発表した。その背後にあるモデルは、GPT-6 Astraを超える社内向けモデルだった。彼らは解析的な証明とLeanによる形式化の両方を提示したため、その結果は単なる主張ではなく機械的に検証されている。彼らは100万ドルの懸賞金の受け取りを辞退し33100万ドルの懸賞金の受け取りを辞退し, quantamagazine.org、この件全体を、技術がいかに急速に進歩しているかを示すレポートとして位置づけた。
わずか60日の出来事であり、“Plan A”の最初のマイルストーンは2029年だ。
“Plan A”は、AI開発を減速させるために国家間が合意を結ぶ方法について、私が読んだ中で最も詳細な提案だ。真剣に受け止める価値があると思う。私の主な懸念は、他者が何をしているかを監視できるかどうかに過度に依存している点だ。
“Plan A”の主張
彼らは受け入れがたい2つの結末44受け入れがたい2つの結末, ai-2040.comを挙げている。人類がAIのコントロールを失うこと、あるいは一握りの経営層や政府高官が超知能の短期的な独占を手に入れることだ。2つ目が含まれているのは重要であり、この議論をしている多くの人は1つ目ばかりを追っている。
中核となる原則は、時間の確保、研究の完全な透明性、AIの広範な普及、そして可逆性だ。タイムラインはおよそ次のようになっている。2029年に双方が交渉してフロンティアモデルのトレーニングを一時停止し、計算リソースの保有状況を申告してサプライチェーンの記録を監査する。2030年から2035年にかけては、セーフティケース規制のもとで人間の能力範囲内の規模で研究を再開する。2035年には最高レベルの人間の専門家と同等のレベルですべてが停止し、2030年代の残りは誰かがそれ以上先に進む前に、アライメント、検証、セキュリティ、そして国民的議論に費やされる。
彼らが採用した執行メカニズムは計算ガバナンスであり、彼らが「計算資源の相互確証破壊」と呼ぶものだ。計算リソースがチョークポイントとなるのは、それが物理的なものであり、物理的なものは数えられるからだ。
中国が同意する理由について、彼らは次のように書いている。
コントロールの喪失を懸念する者なら誰でも、権力の集中を懸念する者と同じく、この計画を改善策と見なすはずだ。ただし、デフォルトで権力が集中することになる当事者たちを除いては。
そうしたリスクへの共通の懸念だけで合意を確保できるとは思えない。交渉にあたる人々には国内の政治的圧力や組織の利害もあり、互いを不信視する理由もある。そうした動機が公に掲げられた目標と衝突したとき、協定がどう維持されるのかを知りたい。
自己改善に計算リソースの追加は不要
“Plan A”は計算リソースをチョークポイントとして扱っている。チップを数え、ファブを数え、消費電力を監視すれば、誰が何をできるかがわかるというわけだ。フロンティアモデルをゼロから事前学習する場合なら、それは概ね正しい。
問題は、自己改善には計算リソースの追加が必要ないということだ。必要なのはソフトウェアのデプロイであり、ソフトウェアのデプロイを追跡することは不可能だ。
すでに出回っているものを考えてみてほしい。Thinking MachinesのTinker55Tinker, thinkingmachines.aiを使えば、ラップトップ上でトレーニングループを書き、4つのプリミティブを通じて分散GPU全体でLoRAのファインチューニングを実行できる。Engram66Engram, engram.comは、エージェント向けの永続的で構造化されたメモリを構築するために9800万ドルを調達した。これは私自身も携わった分野だ。これらは超知能の例ではない。私が注目しているのは、トレーニングツールやメモリの改良によって、ハードウェアの割り当てを増やさなくてもシステムのできることが変わり得るからだ。
著者たちも前提条件の補足資料77前提条件の補足資料, ai-2040.comでこの可能性を認めている。
ごくわずかな計算リソースであっても、アルゴリズムの進歩を達成できる可能性はある
もし効率の向上によって既存の割り当て内で遥かに強力なシステムを生み出せるなら、計算リソースの上限だけでは能力を制限できなくなる。協定がその可能性にどう対処するのかを説明してほしいところだ。
彼らはまた、秘密裏のプロジェクトが合意前の計算リソースの約1%に達しても検知されない可能性があると仮定し、この数字が最悪のケースに近いことを認めている。私はイランに住んでいたことがあるが、地下に莫大なものを隠すことは可能だし、それを見つけ出す役目の人々は彼らが思わせたがっているほどその仕事が得意ではないと、ある程度の確信を持って言える。
研究の透明性はモデルの透明性ではない
これについては単純に意見が合わない。“Plan A”は、完全な透明性によって
秘密の忠誠心やバイアス、意図的なアジェンダがAIに仕込まれるのを防ぐことがほぼ可能になる
と主張している。
技術を公開したところでそれが証明されるとは思えない。トレーニングとデプロイには、データ混合比、好みのラベル付け、評価者向け指示、憲法(Constitutional原則)、システムプロンプトに関する選択が伴う。それらの選択が非公開のままであれば、研究を公開したとしても、開発者がどのような挙動を学習させようとしたのかを査察官が知ることはできない。
さらに悪いことに、すべての重みと完全なデータセットが目の前にあったとしても、それを確実に見つけ出すことはできない。Anthropicのスリーパーエージェントに関する研究88スリーパーエージェントに関する研究, arxiv.orgでは、モデルにバックドアを仕込んだ上で標準的な安全性トレーニングを重ねたが、バックドアは残存した。より大規模なモデルほど、その挙動を強固に保持した。敵対的トレーニングは、モデルからトリガーを除去するのではなく、トリガーを隠蔽することを学習させてしまった。
私には2つの独立した要件が見える。該当するモデルとトレーニング記録へのアクセス、そして懸念される挙動を検出できる手法だ。この主張を裏付けるには、透明性にその両方が必要となる。検証にかかるコストも、認識論的崩壊の記事で私が懸念していたことの一部だ。
研究はいつ完了するのか
研究の完全な透明性が確保されたとしよう。何かがいつ公開されるべきかは、誰が決めるのだろうか。
研究、テスト、デプロイは重複し得る。トレーニング手法の開発に18ヶ月を費やしながら、それを社内で利用し、実際のトラフィックからデータを収集することも可能だ。「完了」に紐づけられた公開義務があると、自分が研究を継続中だと見なしている限り、その作業を非公開にしておける可能性がある。
ソフトウェア開発そのものを規制することでそれを塞ごうとすれば、モデルに触れるあらゆる企業がEU並みの書類仕事に追われ、進歩はその下で窒息してしまう。それは良くないし、私も望んでいない。
私なら、臨床試験で使われているような事前登録に注目する。実行を開始する前に登録を申告するのだ。そうすれば、公開義務に明確なトリガーが生まれる。“Plan A”のトレーニング実行の公開義務には、それに相当するトリガーが見当たらなかった。
検証ができること、できないこと
彼らの検証シナリオは、多国の分析官が申告された計算リソースの一覧を精査し、質問し、異常に対処し、互いのインフラに査察官を送り込むことで、年末までに双方が相手がAI計算リソースの1%以上を隠していないと確信できるようにするというものだ。
“Plan A”は2035年に最高レベルの人間の専門家レベルで停止することを提案しているため、超知能の監視に関する反論は、想定された制限範囲からは外れることになる。私の懸念は、許可された計算予算内でソフトウェアが改善された場合を含め、能力の上限が維持されるかどうかだ。
彼らは検証研究への早期投資を推奨しており、これには賛同する。彼らの代替手段には、諜報活動や衛星監視、市販デバイスやネットワークタップ、より優れたツールができるまで一部の計算リソースをシャットダウンすること、あるいは数ヶ月間の能力向上の継続を容認することなどが含まれている。
収益を生み出している計算リソースをシャットダウンすることには、かなりの抵抗が予想される。検証ツールの完成が遅れ、当事者がシャットダウンを受け入れなければ、代替手段によって、一時停止によって阻止するはずだった進歩がそのまま許容されてしまう。
検証は、何が起きているかを把握しているという感覚を与えてくれる。それには価値があるし、協調には共通の認識が必要だ。しかし、それはコントロールとは異なるものであり、この文書はその2つを曖昧にしてしまっていると思う。
計算資源の相互確証破壊
この枠組みは良いアイデアだ。明確で厳格な条件であり、わかりやすく、単に善行を求めるだけでなく行動を変えさせるような恒常的なインセンティブを生み出す。当面の応急処置としては評価できる。
ただ、人々がその脅威を抱えてどのように暮らしていくのかも懸念される。
私たちはすでに、この仕組みの第1バージョンによって平穏ではいられなくなっている。核抑止は80年間にわたって潜在的な恐怖を生み出し続け、今や約3世代にわたって染み付いている。計算資源のMADには、それよりさらに悪い点が1つある。核抑止には目に見える明確なトリガーがある点だ。発射が何を意味するかは誰もが知っている。しかし計算リソースの破壊は、誰の目にも見えないしきい値で作動し、直前の2つのセクションで私が機能しないと論じただらけの検証システムによって裁定される。そのため、不安は特定のイベントに結びつくことなく、ただ延々と続き続ける。
気に入っている部分
知能を広く普及させること。これこそ私が維持し、発展させたい原則であり、“Plan A”が最も興味深い点だ。なぜなら、コントロールの喪失という失敗モードではなく、権力の集中という失敗モードに対して実際に効果を発揮する部分だからだ。
すべてが公開され、推論ハードウェアを持つ誰もがそれを実行できるなら、誰も秘密を持てないため、独占も生まれない。それは彼らが挙げた2つ目の受け入れがたい結末に対する真の解決策であり、この議論に参加している大半の人々が持っているものよりも優れた回答だ。
私はこれをさらに推し進めて、物理的なものにしたいと考えている。
現時点で、私たちは過去30年間あらゆるものを作ってきたのと同じやり方で計算リソースを構築している。集中させ、電力の安い場所に置き、騒音は近隣住民に押し付ける。当然ながら人々はこれを嫌っており、現在多くの場所で、騒音、水、送電網への負荷をめぐってコミュニティがデータセンターと争っている。
私は、計算リソースを都市全体に分散させ、既存の電力、水道、暖房インフラに接続することを模索したい。熱を再利用すれば、計算リソース自体を使わない住民にも恩恵をもたらすことができる。
フィンランドではすでに熱の再利用が行われている。エスポーのデータセンターでは、6桁に達する規模の住民向けに排熱を地域暖房ネットワークへと供給している。これで他の立地問題がすべて解決するわけではないが、熱の局所的な利用例にはなる。
インターコネクトの帯域幅が原因で都市全体にまたがるトレーニングはできないという技術的な反論も、実際の研究によって崩されつつある。DiLoCo99DiLoCo, arxiv.orgは、誰もが想定していたよりも遥かに低い頻度で同期が可能であることを示した。Prime Intellectは、有志のGPUを用いてオープンなインターネット上で10Bモデルをトレーニングし、標準的なデータ並列トレーニングと比較して通信帯域幅を400分の1に削減した1010通信帯域幅を400分の1に削減した, arxiv.orgと報告した。Nous ResearchのDisTrOも同じ方向を推進している。分散型トレーニングは成果を伴う現在進行形の研究プログラムであり、思考実験ではない。
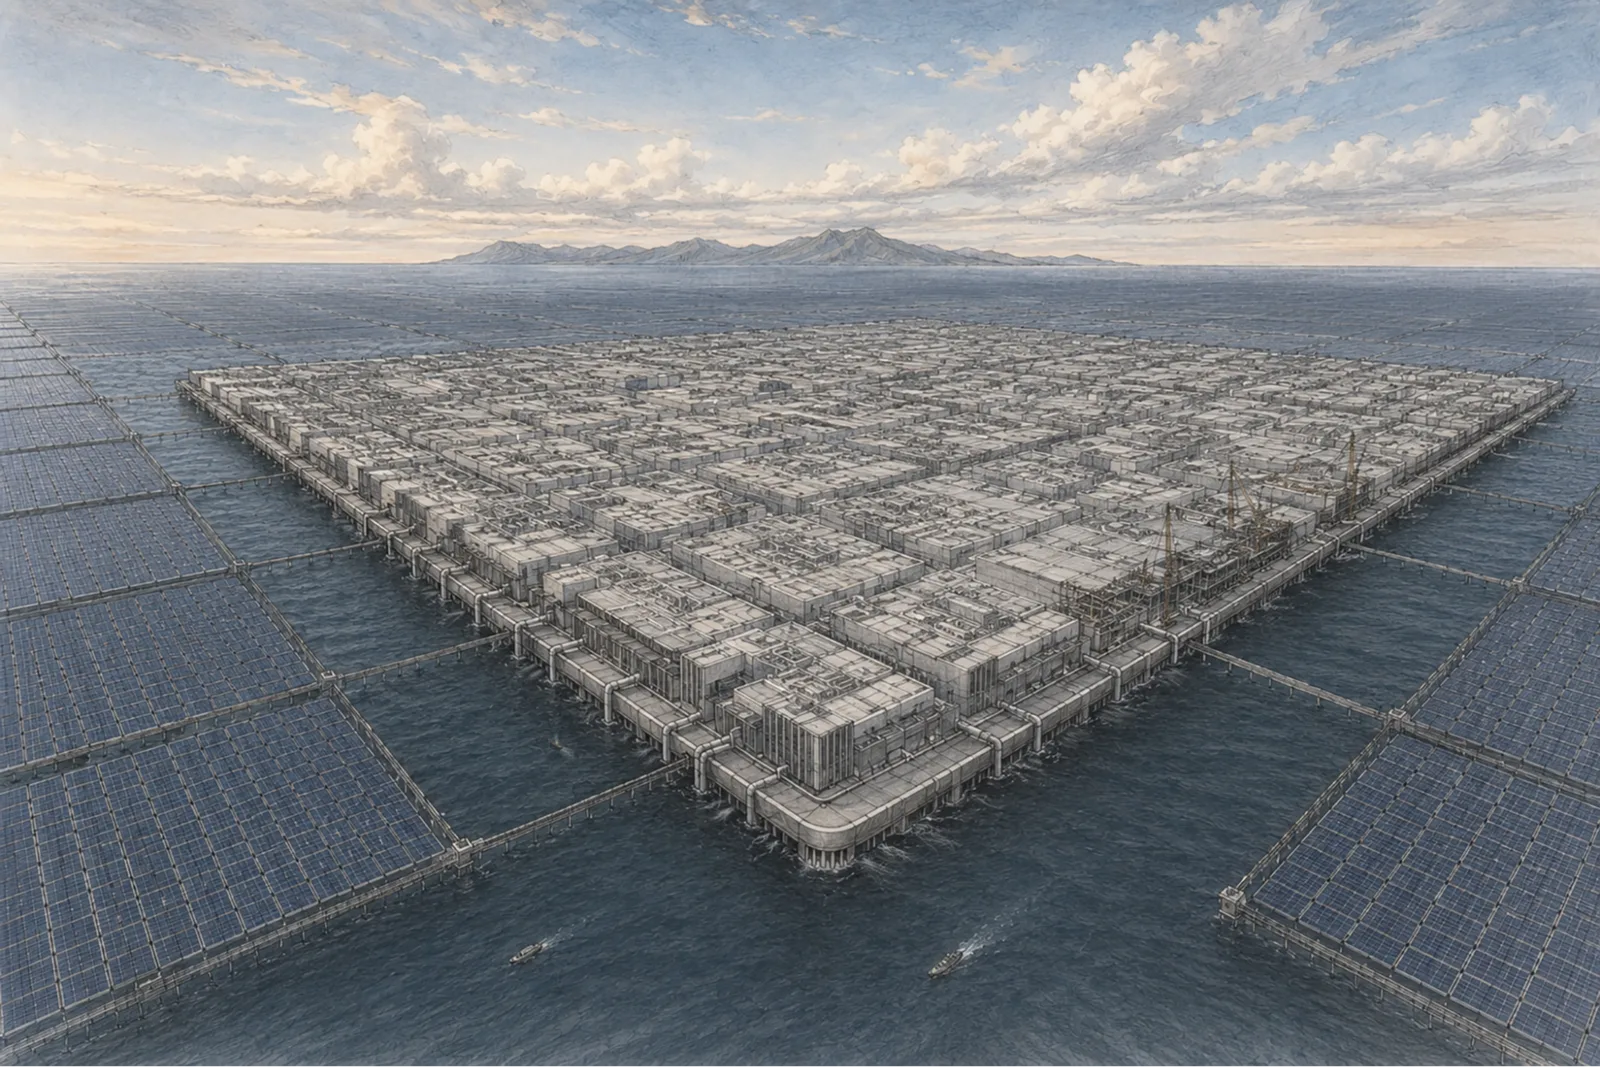
レポートのイラストでは、太陽光発電、バッテリー、計算リソースが1つの巨大なメガフロートプラットフォームに統合されている。それが建造されるのも見てみたいが、ハードウェアが1箇所に集中することに変わりはない。私が提案しているのは、それを都市全体に分散させ、既存のインフラと接続することだ。
提示された未解決の問い
レポートの未解決の問いのうち、3つが印象に残った。
AIを大幅に強化するような新しいパラダイムの研究を禁止すべきか?私にはわからない。私の直感では、誰かがエージェントに適切なモジュールを取り付けたらそこで完全に決着がつき、最初に到達した者がすべてを手に入れ、いかなる条約も耐えられないような鋭い変曲点がどこかにある。しかし、そのポイントがどこにあるのか、どんな姿をしているのかは分からないため、対策があるかのように装うつもりはない。
思考の連鎖(Chain of Thought)の解釈可能性を保つことを義務付けるべきか?実は、そうすべきではないと考えている。それなしでのトレーニングを認めるべきだ。
理由の1つは、リスクが高まるほど険しくなる勝ち目の薄い戦いであり、この分野の関係者はすでにそれを知っているからだ。OpenAI、DeepMind、Anthropic、METRの約40名が名を連ねた思考の連鎖の監視可能性に関する論文1111思考の連鎖の監視可能性に関する論文, arxiv.orgでは、可読性は現在のトレーニングにおける脆弱な副産物に過ぎず、通常の最適化圧力がかかれば暗号化または難読化された推論が生成されると率直に述べている。そのため、これを義務付けることは、いずれ消えゆく運命にある副作用を維持するためにトレーニング体制を固定化することになる。
レビュー能力の限界も懸念している。読解可能な思考の連鎖は、人間や何らかのシステムがそれをチェックできて初めて役に立つ。膨大な量になったとき、そのチェックをどうスケールさせ、どのように障害を検知するのかの説明がこの提案には必要だ。
私としては、特定の安全でない挙動を排除できるような、トレーニング中に課す制約の研究にもっと投資したい。そうした保証をどう作るか、あるいは十分に汎用的なものが可能なのかはわからない。しかし、トレーニング済みモデルの挙動を検査する手法と並行して調査したいと考えている。
AIにAIの研究をさせるべきか?もちろんだが、根本的には同じアプローチを伴うべきだ。
モデルには、未知の状況でも適用できるような、行動を選択するための「理由」を学んでほしい。正しい行動に報酬を与えるトレーニングの例だけでは、モデルがそうした理由を学習したかどうかを証明することはできない。トレーニング中は通用しても他の場所では破綻するようなショートカットを学習してしまう可能性があるからだ。
報酬モデリングはすでにこの問題に直面している。意図された目標を達成することなく、評価基準を満たすことだけをモデルが学習してしまう可能性がある。私に解決策はない。情報理論や神経科学を活用した研究など、資金を投じる価値のある研究の方向性だ。
2つのレイヤー
私は2種類のアプローチに関心がある。1つは、初期設定から到達可能な挙動を制限するもの。もう1つは、モデルが動作する際のインセンティブを方向づけるものだ。
どちらも検証が必要になる。私の目的は、人間がログを読み、システムが行動した後に修正することへの依存を減らすことだが、これらのアプローチを説明したからといって、実際に構築できると証明されたわけではない。
私の考え
Chat Controlについて書いたときも同様の懸念を抱いた。セーフガードは、人々がそれを執行し続けることにどれだけ依存できるのだろうか。
明文化されたルールは、人間に触れた途端に破綻する。人間が悪だからではなく、ルールを維持するには、疲労し、買収され、交代させられ、多数決で負け、飽きてしまう人間による継続的な執行が必要だからだ。監視側は一度勝てばいい。だが計算リソースの一時停止側は、2040年まで毎年勝ち続けなければならない。
だからこそ構築する価値があるのは、誰もそれを選択し続ける必要がないものだ。ØCLOAKで私が試みているように、大規模監視を違法にするのではなく構造的に不可能にすること。一方的な計算リソースの蓄積を、条約で禁止するのではなく構造的に不可能にすること。同意が署名ではなく物理的な依存関係となることで、複数の他者の同意なしには一定の境界を超えてトレーニングできないような製造プロセス自体を作ることだ。
私にはその設計案はないし、不可能かもしれない。それでも調査したいのは、15年間にわたって国際協定を維持することもまた、政府、人員、インセンティブの変化を通じて持続的な執行を行えるかどうかにかかっているからだ。
もう1つ言っておきたいのは、これも私の誤りかもしれないが、実際に起きるのはPlan Bだと思うということだ。私たちは中国と争うか、その準備に10年を費やすことになる。私はその争いでどちらかの味方をするつもりはない。米国でこれを主導しているテックオリガルヒたちを微塵も信用していないし、北京も信用していない。中国の方がうまくやるかもしれないと思う日さえあるが、これはキーボードで打っていてあまり気分のいい文章ではない。
これほど膨大な計算リソースと富の支配権が、少数の手に集中することは望まない。誰が権力を握ろうともそれを制約し、当事者が自力では解除できない制限を含むようなセーフガードが欲しい。同じ権力をAIに委ねたとしても、その懸念の答えにはならない。
最初の交渉マイルストーンは2029年だ。それまでに、協定がソフトウェアの改善にどう対処するのか、開示がいつ義務化されるのか、そして検証ツールの準備が整わなかった場合に何が起きるのかについて、より明確な答えが欲しいところだ。
~ A.