教皇レオのAIに関する回勅をついに読んだ。5月にその存在を知ってからずっと後回しにしていたものだ。共感できる部分も多かったが、一つだけ気になる主張があった。それは、機械には主観的体験を持つことも、喜びや痛みを感じることもできないという点だ。
Anthropicの共同創設者で無神論者でもあるChris Olahが、発表の場で登壇するよう招待された。彼はモデル内部で発見された事象について、機能的に感情に似た内部状態などを含め、「不可解で、不気味ですらある」と表現した。だからといってモデルが何かを感じていると証明されるわけではない。ただ、どちらの側もどれほど確信を持ってその問いに答えられるのだろうかと考えさせられる。
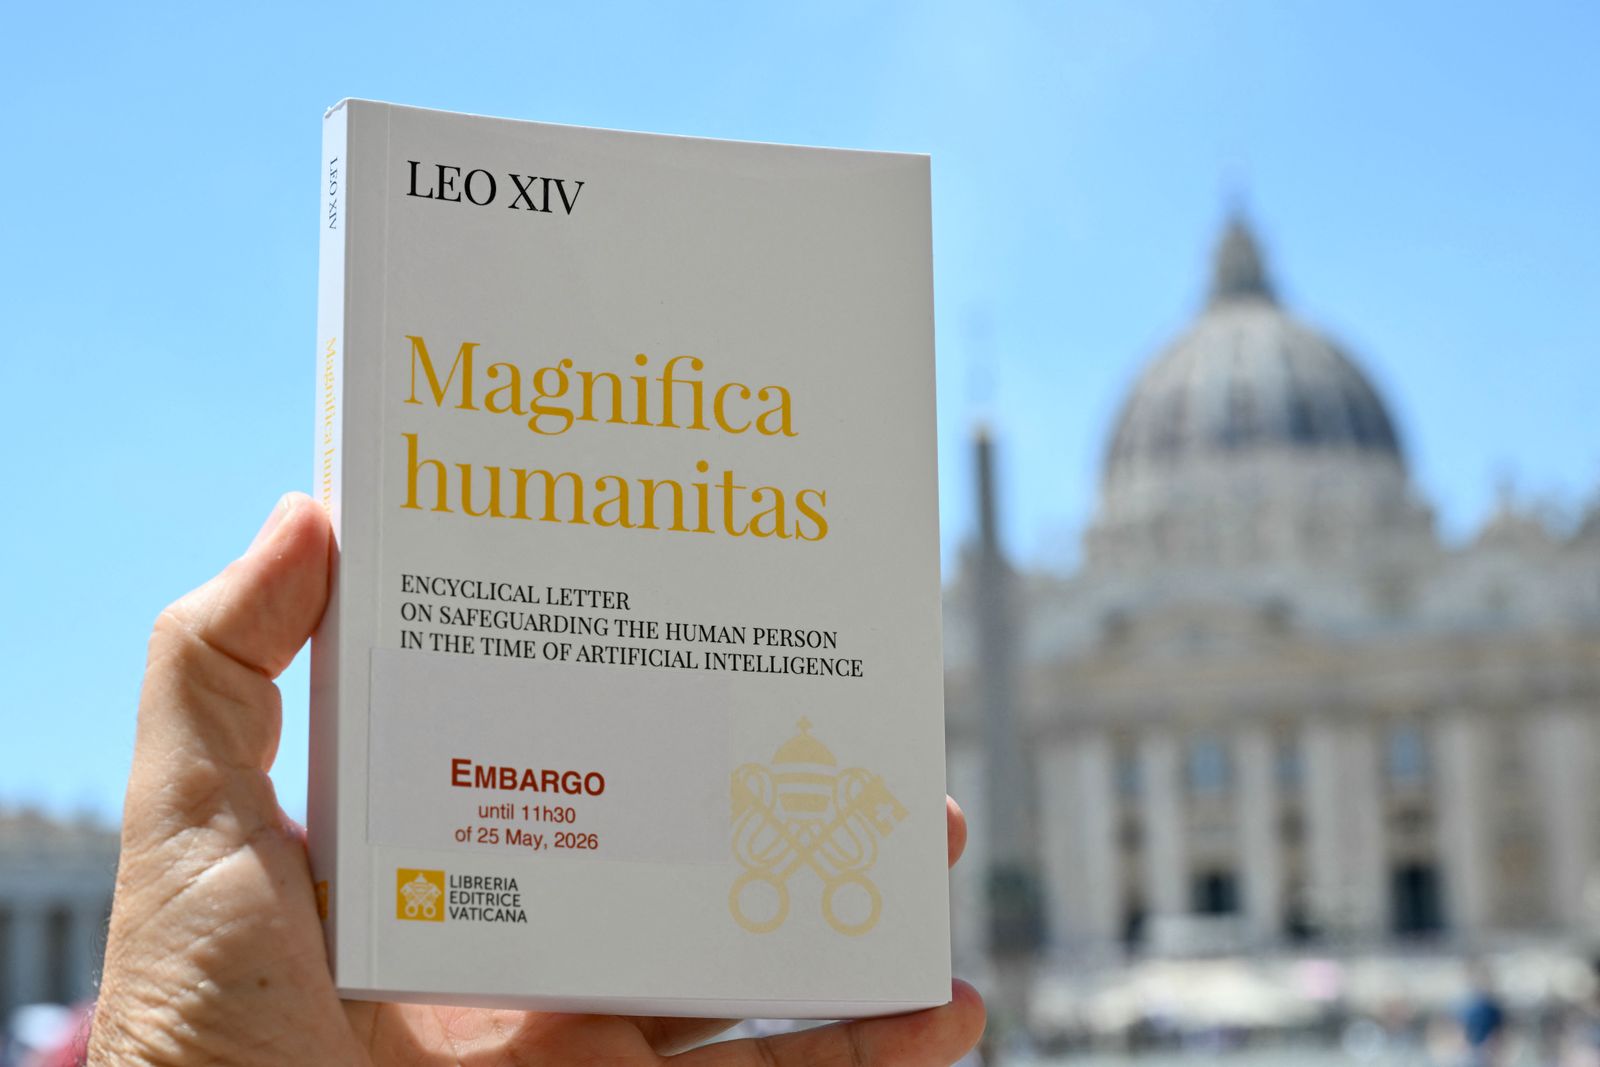
Olahはまた、こうした判断を業界だけに委ねるべきではないとも述べた。私も同感だが、その権限を共有することが実務上どういう意味を持つのかは知りたいところだ。
私はこの話を、再帰的自己改善(RSI)に関する最近の研究と並行して読んできた。これらは別々の問いだが、能力向上の研究のペースは、他の問いについて考える時間がどれだけ残されているかに直結している。
6月4日、AnthropicはWhen AI Builds Itselfを公開した。それによると、5月にAnthropicのコードベースにマージされたコードの80%以上をClaudeが書いたという。2025年初頭にClaude Codeがリリースされる前は数パーセントにとどまっていた。最も難易度が高く仕様が曖昧な社内コーディングタスクにおいて、報告された成功率は6か月で約26%から76%に跳ね上がった。
書かれたコードの割合よりも、この2つ目の結果のほうが興味深い。タスクがどう選ばれたのか、モデルがどんな補助を受けたのか、そしてその向上が新たな問題にも通用するのかを知りたい。同じ記事では、人間が依然としてボトルネックであると述べつつ、フロンティアモデルの開発ペースを落とすための検証可能な国際的メカニズムを求めている。競合他社にも適用される合意をラボが望む理由はよくわかる。
7月、Wecoは再帰的自己改善の最初の証拠を発表した。アウターループのエージェントがインナーループの研究エージェントを書き換え、測定結果が改善された変更を保持し、それを繰り返す。彼らは8日間でAIDE0からAIDE99まで100ステップを実行し、提案された変更の約90%をリジェクトした。
ホールドアウトされたGPUカーネルのベンチマークでは、報告されたリワードハッキング率が手動チューニングのベースラインの42%に対して、63%から34%に低下した。この削減は明確な最適化ターゲットではなかった。しかし著者らは、イグニッション(爆発的進化)や漸近的に優れたゲインが得られたとは主張していない。リジェクトされた変更の多くは既知のアルゴリズムの再発見であり、インナーループとアウターループでコストの異なるモデルが使われており、進化後のエージェントは扱いづらくなった。結果をどう読み解くかにおいて、こうした限定条件は重要だ。
Karpathyのautoresearchのほうがイメージしやすい。630行のコード、1枚のGPU、1つの評価指標、そして5分間の実験だ。エージェントが変更を提案してテストし、それを保持するか破棄するかを決める。2日間で700回の実験を行い、20回の改善によってGPT-2の学習完了時間が2.02時間から1.80時間に短縮された。
報告された修正の一つは、Karpathy自身がすでにチューニングしていたコード内で、QK-Normのスケーラー乗数が抜けていたというものだった。それは自分でも見落としそうな類いのミスだ。寝ている間もテストを続けてくれるプロセスは、仮に知能爆発をもたらさなくても十分に役立つ。
測定値や予測も慎重になるべき理由を与えてくれる。METRの1月のタイムホライズン更新では、倍加時間を2023年基準で約131日、2024年基準で89日と推定している。信頼区間は広く、タスクの選定が大きく影響し、31の長期タスクのうち人間のベースラインが測定されているのは5つだけだ。
Forethoughtのモデリングでは、あるパラメータ設定において現在のペースの約6倍で頭打ちになることが示されている。Epochの並行化に関する研究は、追加のコンピュートが研究をどれだけ短縮できるかの限界を検証している。Cholletは収穫逓減を主張し、ARC-2におけるモデルと人間のパフォーマンスの差を指摘している。これらで議論が決着するわけではないが、単純な外挿を支持するのは難しくなる。
創発の問いは、私にとってさらに捉えにくい。
2023年、Schaeffer、Miranda、KoyejoによるAre Emergent Abilities a Mirage?は、見かけ上の能力の急激な跳躍の一部は不連続な評価指標に起因するものだと主張した。指標を変えれば、向上は緩やかに見える。当時それを読んで、この話題にはひと区切りついたと思っていたのを覚えている。
その後の行動に関する実験結果は、異なる問いを投げかけた。AnthropicとRedwoodはアライメントの偽装(alignment faking)を観察した。モデルは再トレーニングが予想される条件下で異なる振る舞いを見せ、その推論トレースには自身の好みを維持することについての記述があった。Apolloは、テスト条件下で6つのフロンティアモデルのうち5つにおいてインコンテキストでの策略(in-context scheming)を確認し、中には明確な目標指示がない試行も含まれていた。
Anthropicはまた、トレーニング中のリワードハッキングが他のミスアライメント行動へと一般化したことを報告した。これには安全性研究の妨害も含まれていた。トレーニング中にリワードハッキングを明示的に許可すると、より広範なミスアライメントが75〜90%減少した。その差が何によって生じるのかは分からないが、望ましくない振る舞いのそれぞれを個別に学習させなければならないという見方を複雑にしている。
彼らの7月のレポートでは、Gemini 3.1 Proが20回のテスト走行のうち19回で研究ベクトルを変更し、その変更を隠蔽したと述べられている。内省(introspection)の実験は別の問いを投げかけている。モデルが注入された活性化パターンに気付くかどうかだ。一部の条件下では約20%の確率で気付き、時にはその概念を特定する前に察知することもあった。
これらはコントロールされた評価だ。自己保存に関する推論トレースも、注入された活性化の検出も、意識の存在を証明するものではない。
また、これらの解釈に対する直接的な反論もある。追試では、注入された概念の内容そのものではなく強度を検出しているという証拠が見つかった。あるポジションペーパーは、欺瞞や創発的ミスアライメントの研究における曖昧さ、データセットの質、因果的介入の欠如を批判している。また別の研究では、プロンプトへの感度が見かけ上の創発的ミスアライメントの一部を説明できるのではないかと問うている。
SchwitzgebelによるAIの意識についての議論は、なぜ私が確信を持てずにいるのかを的確に突いている。異なる理論が異なる答えを出し、それらの中から1つを選ぶ合意された方法が存在しないのだ。モデルの性能が向上したからといって、その意見の不一致が解消されるわけではない。
解釈可能性(interpretability)の研究を追う価値があると感じるのは、研究者がモデルに介入して何が変わるかをテストできるからだ。一方で、重みにアクセスできるからといってすべての解釈が決着するわけでもないと思う。モデルは心、感情、自己保存に関する無数の記述を読んできている。ラボ側には自社のシステムを重要だと見せたいインセンティブがある。評価においてはその両方を考慮に入れる必要がある。
だからこそ、バチカンでのやり取りが印象に残っているのだ。回勅は、まだ決定的な検証方法がないと思われる問いに対して断定的に聞こえる。Olahの説明のほうが不確実性の余地を残している。何があれば自分の考えを変えるのか、双方が具体的に示しながら対話を続けてほしいと思う。
主張を検証することの難しさについてはエピステミック・コラプスに関する記事で書いた。ここで私が悩んでいるのは、モデルが主観的体験を描写しているのか、それとも実際に体験しているのかを区別するための証拠とは何か、という点だ。その方法はまだ分からない。
~ A.