Låt oss prata om Plan A
AI Futures Project vill att USA och Kina ska pausa superintelligens fram till 2040. Det är en bra plan. Sextio dagar efter att de publicerade den löste tiotusen agenter Navier-Stokes.
Tajmingen
Den 9 juli 2026 publicerade AI Futures Project AI 2040: Plan A11AI 2040: Plan A, ai-2040.com. Den är på nittio sidor. Förslaget är att USA och Kina förhandlar fram till 2029, deklarerar sina beräkningsresurser, släpper in varandras inspektörer i sin infrastruktur, pausar frontlinjeträning och sedan ägnar ett decennium åt att bedriva alignment-forskning helt öppet innan någon bygger något som är smartare än den smartaste människan. Superintelligens skjuts fram till 2040 och alla överlever.
Den 8 september 2026 meddelade OpenAI att omkring tiotusen koordinerande autonoma agenter hade hittat en singularitet i ändlig tid i 3D-Navier-Stokes-ekvationerna22omkring tiotusen koordinerande autonoma agenter hade hittat en singularitet i ändlig tid i 3D-Navier-Stokes-ekvationerna, openai.com. Modellen bakom var en intern modell ovanför GPT-6 Astra. De producerade både ett analytiskt bevis och en Lean-formalisering, så resultatet är maskinverifierat snarare än bara påstått. De avstod från att göra anspråk på miljonen dollar33avstod från att göra anspråk på miljonen dollar, quantamagazine.org och ramade in det hela som en rapport om hur snabbt det här går.
Det är sextio dagar, och den första milstolpen i “Plan A” är 2029.
“Plan A” är det mest detaljerade förslaget jag har läst om hur länder skulle kunna komma överens om att bromsa AI-utvecklingen. Jag tycker det är värt att ta på allvar. Min främsta invändning är hur mycket som hänger på att kunna observera vad andra parter gör.
Vad “Plan A” säger
De nämner två utfall de anser vara oacceptabla44två utfall de anser vara oacceptabla, ai-2040.com: att mänskligheten förlorar kontrollen över AI, eller att en liten grupp företagsledare och makthavare slutar med ett tillfälligt monopol på superintelligens. Att det andra finns med spelar roll, och många som diskuterar detta håller bara koll på det första.
Kärnprinciperna är att köpa tid, total forskningstransparens, bred spridning av AI och reversibilitet. Tidslinjen ser ungefär ut så här: År 2029 förhandlar de två sidorna och pausar frontlinjeträning, deklarerar sina beräkningsresurser och granskar dokumentation i leveranskedjan. Från 2030 till 2035 återupptas forskning i stor skala inom det mänskliga spannet under säkerhetsfallsreglering. År 2035 stoppas allt vid nivån för mänskliga toppexperter, och resten av decenniet ägnas åt alignment, verifiering, säkerhet och offentlig debatt innan någon går vidare.
Verkställighetsmekanismen de landar i är compute governance, tillsammans med vad de kallar ömsesidigt garanterad beräkningsförstörelse. Beräkningskraft är flaskhalsen eftersom den är fysisk, och fysiska saker kan räknas.
Om varför Kina skulle gå med på det skriver de:
anyone concerned about a loss of control should think this plan is an improvement, along with anyone concerned about the concentration of power, except for the people in whom the power would concentrate by default
Jag tror inte att en delad oro för de riskerna räcker för att säkra en överenskommelse. Personerna som förhandlar skulle också ha inrikespolitiska påtryckningar, institutionella intressen och skäl att misstro varandra. Jag skulle vilja veta hur avtalet håller när de motiven krockar med dess uttalade mål.
Självförbättring kräver inte mer beräkningskraft
“Plan A” behandlar compute som flaskhalsen. Räkna chippen, räkna fabrikerna, håll koll på strömförbrukningen, så vet du vem som kan göra vad. För förträning av en frontlinjemodell från grunden stämmer det i stort sett.
Problemet är att självförbättring inte behöver mer beräkningskraft. Det behöver mjukvarudistribution, och mjukvarudistribution är omöjlig att spåra.
Se på vad som redan skeppas. Tinker55Tinker, thinkingmachines.ai, från Thinking Machines, låter dig skriva en träningsloop på din bärbara dator och köra LoRA-finjusteringar över deras distribuerade GPU:er via fyra primitiver. Engram66Engram, engram.com tog in 98 miljoner dollar för att bygga persistent strukturerat minne för agenter, ett område jag själv har arbetat inom. Det här är inte exempel på superintelligens. De intresserar mig för att bättre träningsverktyg och minne kan förändra vad ett system gör utan en motsvarande ökning i dess hårdvarutilldelning.
Författarna erkänner denna möjlighet i sitt tillägg om antaganden77sitt tillägg om antaganden, ai-2040.com:
it’s possible that algorithmic progress is doable even with a very small amount of compute
Om effektivitetsvinster kan producera mycket starkare system inom en befintlig tilldelning, kommer ett beräkningstak inte i sig att begränsa förmågan. Jag vill att avtalet ska förklara hur det hanterar den möjligheten.
De medger också att de antar att hemliga projekt skulle kunna nå runt 1 % av beräkningskraften före avtalet utan att upptäckas, och medger sedan att den siffran ligger nära det värsta scenariot. Jag bodde i Iran, och jag kan berätta med viss säkerhet att man kan gömma en hel del under jord, och att människorna vars jobb är att hitta det inte är så bra på sitt jobb som de vill få en att tro.
Forskningstransparens är inte modelltransparens
Här håller jag helt enkelt inte med. “Plan A” säger att total transparens
makes it nearly impossible for secret loyalties, biases, or agendas to be intentionally trained into AIs
Jag tror inte att publicering av tekniker säkerställer det. Träning och driftsättning innebär val gällande datamix, preferensetiketter, instruktioner till bedömare, konstitutioner och systempromptar. Om de valen förblir proprietära kommer publiceringen av forskningen inte att tala om för en inspektör vilket beteende utvecklaren försökte träna in.
Det är värre än så, för även med de fullständiga vikterna och hela datasetet framför mig skulle jag inte på ett tillförlitligt sätt kunna hitta det. Anthropics arbete om sleeper agents88arbete om sleeper agents, arxiv.org tränade in bakdörrar i modeller och körde sedan vanlig säkerhetsträning ovanpå, och bakdörrarna överlevde. Större modeller höll fast vid beteendet starkare. Adversariell träning lärde modellerna att dölja triggern istället för att bli av med den.
Jag ser två separata krav: tillgång till relevant modell och träningsloggar, samt metoder som kan upptäcka det beteende man oroar sig för. Transparens behöver båda för att stödja det påståendet. Kostnaden för att granska är också en del av det som oroade mig i inlägget om epistemisk kollaps.
När är forskning färdig?
Säg att vi har total forskningstransparens. Vem bestämmer när något ska publiceras?
Forskning, testning och driftsättning kan överlappa. Jag skulle kunna ägna arton månader åt att utveckla en träningsteknik samtidigt som jag använder den internt och samlar in data från verklig trafik. Ett publiceringskrav kopplat till slutförande skulle kunna låta mig hålla det arbetet privat medan jag fortfarande ansåg att forskningen pågick.
Om man försöker täppa till det genom att reglera själva mjukvaruutvecklingen, slutar man med pappersarbete i EU-klass kring varje företag som rör en modell, och utvecklingen dör under det. Det är dåligt och jag vill inte ha det heller.
Jag skulle titta på förhandsregistrering, som det används i kliniska prövningar: deklarera körningen innan den startas. Det skulle ge publiceringskravet en tydlig utlösare. Jag kunde inte hitta någon motsvarande utlösare i “Plan A”:s krav på att publicera träningskörningar.
Vad verifiering kan och inte kan göra
Deras bild av verifiering är att analytiker från många länder går igenom de deklarerade beräkningslistorna, ställer frågor, ifrågasätter avvikelser och skickar inspektörer till varandras infrastruktur, så att vardera sidan i slutet av året känner sig trygg med att den andra inte gömmer mer än 1 % av sin AI-beräkningskraft.
“Plan A” föreslår att stoppa vid nivån för mänskliga toppexperter år 2035, så en invändning om att övervaka en superintelligens skulle missa dess avsedda gräns. Min oro är om kapacitetstaket håller, även när mjukvaran förbättras inom den tillåtna beräkningsbudgeten.
De rekommenderar tidiga investeringar i verifieringsforskning, vilket jag stödjer. Deras reservalternativ inkluderar underrättelseinhämtning och satellitövervakning, standardutrustning och nätverksavlyssning, att stänga ner viss beräkningskraft tills bättre verktyg finns, eller att låta kapacitetsutvecklingen fortsätta i flera månader.
Jag förväntar mig ett betydande motstånd mot att stänga ner intäktsgenererande beräkningskraft. Om verifieringsverktyg dröjer och parterna inte accepterar den nedstängningen, tillåter reservalternativet de framsteg som pausen var tänkt att stoppa.
Verifiering ger oss en känsla av att vi vet vad som pågår. Det är värt något, och koordinering kräver en delad uppfattning. Men det är en annan sak än kontroll, och jag tycker dokumentet låter de två flyta ihop.
Ömsesidigt garanterad beräkningsförstörelse
Inramningen är en bra idé. Det är ett verkligt hårt villkor, det är tydligt och det skapar den typ av ständigt incitament som förändrar beteende snarare än att bara beskriva ett gott beteende. Jag gillar det som en nödlösning.
Jag oroar mig också för hur folk skulle leva med det hotet.
Vi mår redan inte bra av den första versionen av detta. Kärnvapenavskräckning har skapat en bakomliggande fasa i åttio år och är vid det här laget inpräntad i ungefär tre generationer. Beräknings-MAD är värre på ett specifikt sätt, nämligen att kärnvapenavskräckning har en synlig, distinkt utlösare. Alla vet vad en avfyrning är. Beräkningsförstörelse utlöses vid ett tröskelvärde som ingen kan se, bedömt av verifieringssystem som jag precis ägnat två avsnitt åt att argumentera för att de inte fungerar. Så ångesten får aldrig fäste vid en specifik händelse, utan pågår bara oavbrutet.
Delen jag gillar
Att sprida intelligens brett. Det här är principen jag skulle behålla och bygga vidare på, och det är där “Plan A” är som mest intressant, eftersom det är den del som faktiskt gör ett reellt arbete mot felscenariot med maktkoncentration istället för det med förlorad kontroll.
Om allt publiceras och vem som helst med inferenshårdvara kan köra det, då får ingen monopol, för ingen får någon hemlighet. Det är ett genuint svar på deras andra oacceptabla utfall, och det är ett bättre svar än vad de flesta i den här debatten har.
Jag skulle vilja ta det längre och göra det fysiskt.
Just nu bygger vi beräkningsresurser på samma sätt som vi har byggt allt annat i trettio år. Koncentrera det, placera det någonstans med billig el och låt grannarna hantera bullret. Folk hatar detta, fullt rimligt, och det finns lokalsamhällen som kämpar mot datacenter över buller, vatten och nätbelastning på många platser just nu.
Jag skulle vilja utforska att sprida ut beräkningskraft över en hel stad och koppla ihop den med befintlig infrastruktur för el, vatten och värme. Att återanvända värmen skulle kunna gynna invånare som inte själva använder beräkningskraften.
Finland gör redan värmeåteranvändningsdelen: ett datacenter i Esbo matar in spillvärme i fjärrvärmenätet för ett sexsiffrigt antal människor. Det löser inte de andra lokaliseringsproblemen, men det är ett exempel på en lokal användning av värmen.
Den tekniska invändningen, att man inte kan träna över en hel stad på grund av sammankopplingsbandbredd, håller på att ätas upp av faktisk forskning. DiLoCo99DiLoCo, arxiv.org visade att man kan synkronisera mycket mer sällan än vad alla trodde. Prime Intellect tränade en 10B-modell över det öppna internet på frivilligt upplåtna GPU:er och rapporterade en 400x minskning av kommunikationsbandbredden1010rapporterade en 400x minskning av kommunikationsbandbredden, arxiv.org jämfört med standardmässig dataparallell träning. Nous Researchs DisTrO rör sig i samma riktning. Decentraliserad träning är ett levande forskningsprogram med resultat, inte ett tankeexperiment.
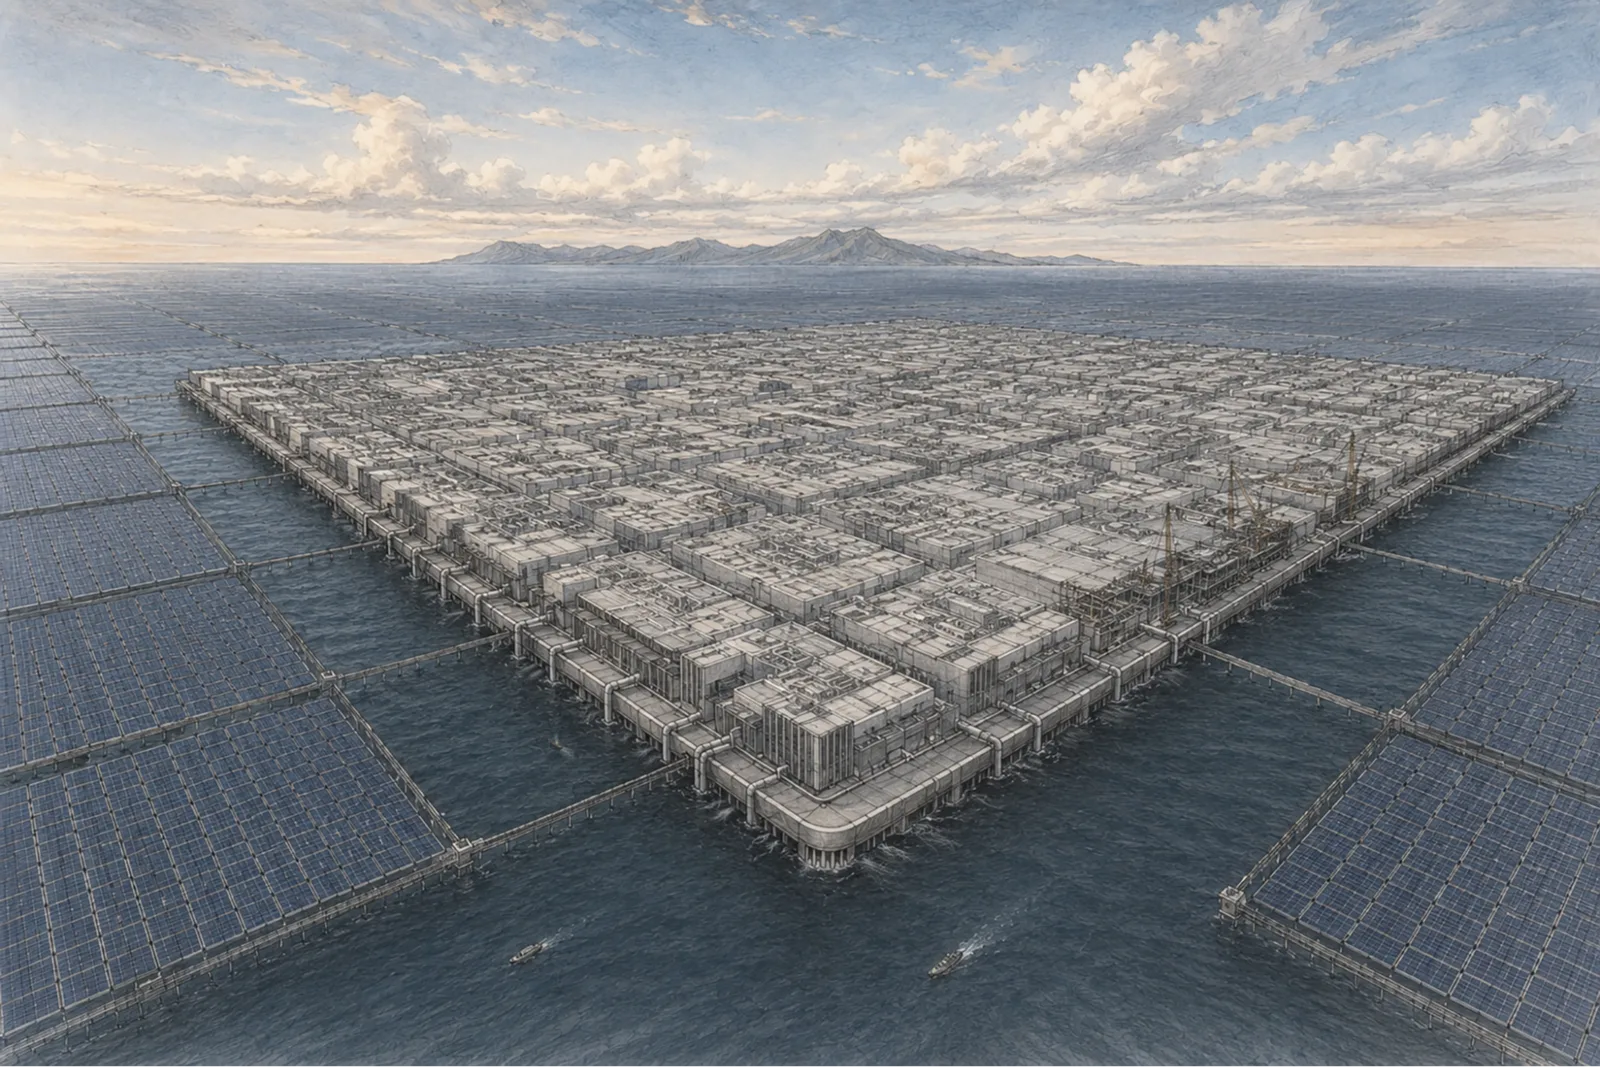
Rapportens illustration kombinerar solenergi, batterier och beräkningskraft på en stor flytande plattform. Jag skulle vilja se det byggas, men det koncentrerar fortfarande hårdvaran till en enda plats. Det jag föreslår skulle distribuera den över en stad och ansluta den till befintlig infrastruktur.
Deras öppna frågor
Tre av rapportens öppna frågor dröjde sig kvar hos mig.
Borde vi förbjuda forskning om ett nytt paradigm som skulle göra AI betydligt mer kapabla? Jag vet inte. Min magkänsla är att det finns någon skarp böjningspunkt där ute där någon kopplar rätt modul till en agent och sedan är det helt enkelt över, och den som hinner först har det, och inget avtal överlever det. Men jag kan inte säga var den punkten finns eller hur den ser ut, så jag tänker inte låtsas ha en policy.
Borde vi kräva att tankekedjor förblir tolkningsbara? Egentligen inte, tycker jag. Låt folk träna utan det.
Delvis för att det är en uppförsbacke som blir brantare i exakt samma takt som insatserna ökar, och fältet vet redan om detta. Uppsatsen om övervakningsbarhet hos tankekedjor1111övervakningsbarhet hos tankekedjor, arxiv.org, undertecknad av ett fyrtiotal personer från OpenAI, DeepMind, Anthropic och METR, säger öppet att begriplighet är en bräcklig tillfällighet av nuvarande träning och att vanligt optimeringstryck producerar kodade eller fördunklade resonemang. Så ett mandat låser ett träningssystem bara för att bevara en bieffekt som ändå är på väg bort.
Jag är också orolig för granskningskapaciteten. En läsbar tankekedja är bara användbar om någon eller något kan granska den. Vid stora volymer behöver förslaget en förklaring till hur den granskningen skalar och hur fel upptäcks.
Jag skulle hellre lägga mer forskning på begränsningar som införs under träningen och som kan utesluta specifika osäkra beteenden. Jag vet inte hur man ger sådana garantier, eller om en tillräckligt generell version är möjlig. Men jag skulle vilja undersöka det tillsammans med metoder för att inspektera vad en tränad modell gör.
Borde vi låta AI:er forska om AI? Ja, definitivt, men med samma reservation i botten.
Jag vill att modeller ska lära sig skäl för att välja en handling som fortfarande gäller i obekanta situationer. Träningsexempel som belönar rätt beteende visar inte i sig att modellen har lärt sig de skälen. Den kan lära sig en genväg som fungerar under träning och fallerar på andra håll.
Belöningsmodellering har redan det här problemet: en modell kan lära sig att tillfredsställa mätningen utan att uppnå det avsedda målet. Jag har ingen lösning. Det är en forskningsriktning jag skulle finansiera, inklusive arbete som bygger på informationsteori och neurovetenskap.
Två lager
Jag är intresserad av två typer av interventioner. Den ena skulle begränsa de beteenden som är nåbara från den initiala uppsättningen. Den andra skulle forma incitamenten som styr modellen medan den arbetar.
Båda skulle behöva validering. Mitt mål är att minska beroendet av en människa som läser transkriberingar och korrigerar systemet efter att det har agerat, men att beskriva dessa interventioner bevisar inte att vi kan bygga dem.
Vad jag tänker
Jag hade en liknande oro när jag skrev om Chat Control: hur mycket kan en skyddsåtgärd förlita sig på att människor fortsätter att upprätthålla den?
Uttalade regler överlever inte kontakten med människor. Inte för att människor är onda, utan för att regler kräver kontinuerlig tillsyn av människor som tröttnar, mutas, byts ut, blir nedröstade och blir uttråkade. Övervakningssidan behöver bara vinna en gång. Sidan för beräkningspaus måste vinna varje enskilt år fram till 2040.
Så det som är värt att bygga är det som inte kräver att någon fortsätter att välja det. Gör massövervakning arkitektoniskt omöjligt istället för olagligt, vilket är vad jag experimenterar med i ØCLOAK. Gör ensidig beräkningsackumulering strukturellt omöjligt istället för fördragsförbjudet. Gör själva tillverkningsprocessen sådan att du inte kan träna bortom en gräns utan ett antal andra personers samtycke, eftersom samtycket är ett fysiskt beroende snarare än en underskrift.
Jag har inte den designen, och det kan vara omöjligt. Jag vill undersöka det eftersom upprätthållandet av ett internationellt avtal i femton år också beror på kontinuerlig efterlevnad genom regeringsskiften, personalbyten och skiftande incitament.
Den andra saken jag vill säga, och jag kan ha fel om detta också, är att jag tror att Plan B är vad som faktiskt händer. Vi slåss mot Kina, eller så ägnar vi ett decennium åt att göra oss redo för det. Jag tar inte ställning i det. Jag litar inte det minsta på teknikoligarkerna som driver detta i USA, jag litar inte heller på Peking, och vissa dagar tror jag att Kina skulle kunna göra ett bättre jobb med det, vilket är en obekväm mening att skriva.
Jag vill inte att kontrollen över så här mycket beräkningskraft och rikedom koncentreras till ett fåtal händer. Jag skulle vilja ha skyddsåtgärder som begränsar vem som än har makten, inklusive gränser som de inte kan ta bort på egen hand. Att överlämna samma makt till en AI skulle inte lösa den oron.
Den första förhandlingsmilstolpen är 2029. Innan dess vill jag ha tydligare svar på hur avtalet hanterar mjukvaruförbättringar, när offentliggörande blir obligatoriskt och vad som händer om verifieringsverktygen inte är redo.
~ A.