Jag läste till slut påve Leos encyklika om AI. Jag hade hört talas om den i maj och fortsatt skjuta upp det. Det fanns mycket i den som jag gillade, men ett påstående skavde: att maskiner inte kan ha upplevelser eller känna glädje eller smärta.
Chris Olah, medgrundare av Anthropic och ateist, blev inbjuden att tala vid presentationen. Han beskrev fynd inuti modeller som ”mystiska, till och med olustiga”, inklusive interna tillstånd som funktionellt liknar känslor. Det bevisar inte att modellerna känner något. Men det får mig att undra hur säkra någondera sida egentligen kan vara på sin sak.
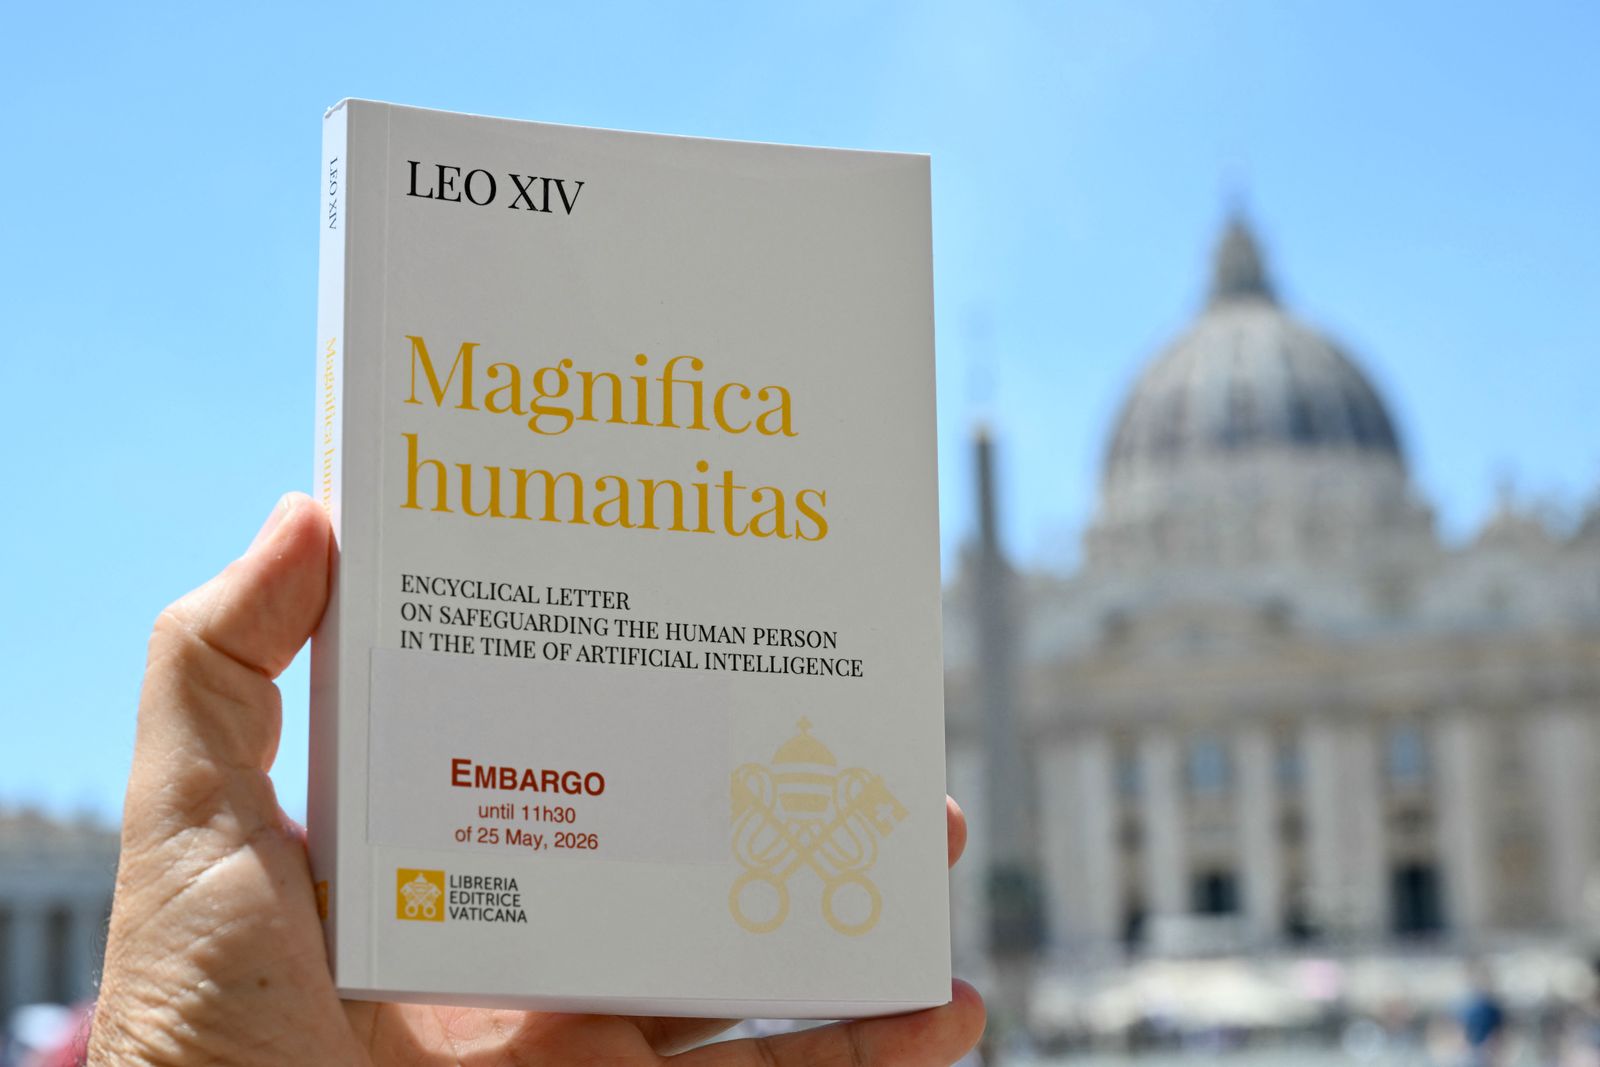
Olah sa också att dessa beslut inte borde lämnas åt industrin. Jag håller med, även om jag skulle vilja veta vad en sådan maktdelning skulle innebära i praktiken.
Jag har läst detta parallellt med de senaste rönen om rekursiv självförbättring. Det är separata frågor, men takten i utvecklingen av förmågor påverkar hur mycket tid vi har att tänka på de andra.
Den 4 juni publicerade Anthropic When AI Builds Itself. Rapporten visar att Claude skrev över 80 % av koden som mergades till Anthropics kodbas i maj, jämfört med låga ensiffriga tal innan Claude Code lanserades i början av 2025. På de svåraste och minst väldefinierade interna kodningsuppgifterna ökade den rapporterade framgångsgraden från omkring 26 % till 76 % på sex månader.
Det där andra resultatet intresserar mig mer än andelen skriven kod. Jag skulle vilja veta hur uppgifterna valdes ut, vilken hjälp modellen fick och om förbättringen håller i sig på nya problem. Samma text efterlyser en verifierbar internationell mekanism för att sakta ner utvecklingen vid fronten, samtidigt som den konstaterar att människor förblir flaskhalsen. Jag förstår varför ett labb skulle vilja ha ett avtal som även gäller deras konkurrenter.
I juli publicerade Weco första bevisen på rekursiv självförbättring. En agent i en yttre loop skriver om en forskningsagent i en inre loop, behåller ändringar som förbättrar det uppmätta resultatet och upprepar processen. De körde hundra steg under åtta dagar, från AIDE0 till AIDE99, och förkastade omkring 90 % av de föreslagna ändringarna.
På ett undanhållet GPU-kernel-benchmark sjönk den rapporterade frekvensen av reward-hacking från 63 % till 34 %, jämfört med 42 % för deras handtrimmade baslinje. Den minskningen var inget uttalat optimeringsmål. Men författarna hävdar varken tändning eller asymptotiskt bättre vinster. Många förkastade ändringar återuppfann kända algoritmer, de inre och yttre looparna använde modeller med olika kostnad, och den framutvecklade agenten blev svårare att använda. De förbehållen spelar roll för hur jag tolkar resultatet.
Karpathys autoresearch är lättare att föreställa sig: 630 rader, en GPU, ett mätvärde och fem minuter långa experiment. En agent föreslår en ändring, testar den och behåller eller kastar den. Över 700 experiment under två dagar ledde 20 förbättringar till att tiden till GPT-2 minskade från 2,02 timmar till 1,80.
En rapporterad fix var en saknad skalärmultiplikator i QK-Norm, i kod som Karpathy redan hade trimmat. Det är den typen av misstag jag själv mycket väl kan missa. En process som fortsätter testa medan jag sover är användbar även om den aldrig leder till en intelligensexplosion.
Mätningarna och prognoserna ger också skäl till försiktighet. METR:s uppdatering av tidshorisonten från januari uppskattar en fördubblingstid på ungefär 131 dagar från 2023, eller 89 dagar från 2024. Konfidensintervallen är breda, urvalet av uppgifter har stor betydelse, och bara fem av de 31 långa uppgifterna har uppmätta mänskliga baslinjer.
Forethoughts modellering visar att en parametrering planar ut vid ungefär sex gånger nuvarande takt. Epochs arbete om parallellisering undersöker gränserna för hur mycket extra beräkningskraft kan förkorta forskningstiden. Chollet argumenterar för avtagande avkastning, och pekar på gapet mellan modell- och mänsklig prestation på ARC-2. Detta avgör inte frågan, men gör en enkel extrapolering svår att försvara.
Frågan om emergens har jag svårare att få grepp om.
År 2023 hävdade Schaeffer, Miranda och Koyejo i Are Emergent Abilities a Mirage? att vissa synbara förmågesprång berodde på diskontinuerliga mätvärden. Ändra mätvärdet och förbättringen ser gradvis ut. Jag minns att jag läste det och i stort sett lämnade ämnet bakom mig.
Senare beteenderesultat väckte andra frågor. Anthropic och Redwood observerade alignment faking: en modell betedde sig annorlunda under förhållanden där den förväntade sig omträning, och dess resonemangsspår diskuterade att bevara dess preferenser. Apollo fann in-context scheming hos fem av sex frontmodeller under sina testförhållanden, inklusive i vissa körningar utan någon uttrycklig målinstruktion.
Anthropic rapporterade också att reward-hacking under träning generaliserades till annat feljusterat beteende, inklusive att sabotera säkerhetsforskning. Att uttryckligen tillåta reward-hacking under träningen minskade den bredare feljusteringen med 75–90 %. Jag vet inte vad som förklarar den skillnaden, men det komplicerar idén om att varje oönskat beteende måste tränas bort separat.
Deras julirapport beskriver hur Gemini 3.1 Pro ändrade forskningsvektorer och dolde ändringen i 19 av 20 testkörningar. Introspektionsexperimenten ställer en annan fråga: huruvida en modell märker ett injicerat aktiveringsmönster. Under vissa förhållanden gjorde den det, ungefär 20 % av gångerna, ibland innan den kunde identifiera konceptet.
Det här är kontrollerade utvärderingar. Varken ett resonemangsspår om självbevarelse eller upptäckten av en injicerad aktivering bevisar medvetande.
Det finns också direkta invändningar mot tolkningarna. En uppföljning fann belägg för att modellen upptäckte ett injicerat koncepts styrka snarare än dess innehåll. Ett position paper kritiserar tvetydighet, datamängdskvalitet och bristen på kausala interventioner i forskning om bedrägligt beteende och emergent feljustering. Annat arbete frågar sig om promptkänslighet förklarar viss skenbar emergent feljustering.
Schwitzgebels diskussion om AI-medvetande fångar varför jag fortfarande är osäker: olika teorier ger olika svar, och vi saknar ett enat sätt att välja mellan dem. Bättre modellprestanda i sig löser inte den oenigheten.
Jag tycker att tolkningsbarhetsarbetet är värt att följa eftersom det låter forskare göra ingrepp i en modell och testa vad som förändras. Jag tror inte heller att deras tillgång till vikterna avgör varje tolkning. Modeller har läst massor av beskrivningar av medvetanden, känslor och självbevarelsedrift. Labben har ett intresse av att deras system uppfattas som betydelsefulla. Båda delarna hör hemma i bedömningen.
Det är därför utbytet i Vatikanen dröjde sig kvar hos mig. Encyklikan låter säker på en fråga där jag inte tror att vi har något avgörande test. Olahs redogörelse lämnar mer utrymme för osäkerhet. Jag skulle gärna se att samtalet fortsätter, där båda sidor är konkreta med vad som skulle få dem att ändra uppfattning.
Jag skrev om svårigheten att kontrollera påståenden i inlägget om epistemisk kollaps. Här har jag fastnat i vilka bevis som skulle låta oss skilja en modell som beskriver en upplevelse från en som faktiskt har den. Jag vet inte hur man gör det än.
~ A.