聊聊 Plan A
AI Futures Project 希望美中两国在 2040 年之前暂停超级智能的研发。这是个好计划。但在他们发布该计划 60 天后,一万个智能体就解出了 Navier-Stokes 方程。
时间节点
2026 年 7 月 9 日,AI Futures Project 发布了 AI 2040: Plan A11AI 2040: Plan A, ai-2040.com。整整有 90 页。该提案建议美中两国在 2029 年前展开谈判,申报各自的算力储备,允许对方检查员进入自身的基础设施,暂停前沿模型训练,然后在任何人造出超越最聪明人类的东西之前,公开进行为期十年的对齐研究。超级智能被推迟到 2040 年,大家都活了下来。
2026 年 9 月 8 日,OpenAI 宣布约一万个协同自主智能体在 3D Navier-Stokes 方程中找到了有限时间奇点22约一万个协同自主智能体在 3D Navier-Stokes 方程中找到了有限时间奇点, openai.com。其背后的模型是高于 GPT-6 Astra 的内部模型。他们既给出了分析证明,也给出了 Lean 形式化证明,因此该结果是经过机器验证的,而非单纯的断言。他们放弃认领这 100 万美元奖金33放弃认领这 100 万美元奖金, quantamagazine.org,并将整件事定性为一份关于当前发展速度有多快的报告。
前后只隔了 60 天,而 “Plan A” 的第一个里程碑是在 2029 年。
“Plan A” 是我读过的关于各国如何就放缓 AI 发展达成一致的最详尽提案。我认为它值得被认真对待。我主要反对的地方在于,它在多大程度上依赖于能够监视其他各方在做什么。
“Plan A” 讲了什么
他们列出了两种他们认为不可接受的后果44两种他们认为不可接受的后果, ai-2040.com:人类失去对 AI 的控制,或者少数高管和官员最终对超级智能形成暂时的垄断。第二点被列入其中至关重要,而许多争论此问题的人往往只关注第一点。
其核心原则是争取时间、全面的研究透明度、广泛普及 AI 以及可逆性。时间线大致如下:2029 年双方谈判并暂停前沿训练,申报算力储备并审计供应链记录。2030 年至 2035 年,在“安全用例(safety-case)”监管下,研究在人类能力范围内大规模恢复。2035 年,一切停留在顶尖人类专家水平,2030 年代剩余的时间用于对齐、验证、安全和公众审议,之后任何人才能更进一步。
他们最终选择的执行机制是算力治理,以及他们所谓的算力相互保证毁灭(mutually assured compute destruction)。算力是卡脖子的瓶颈,因为算力是物理存在的,而物理实体是可以被清点的。
关于中国为什么会同意,他们写道:
任何担心失控的人都应该认为这个计划是一种改进,任何担心权力集中也是如此,除了那些在默认情况下权力会集中到其身上的人
我认为对这些风险的共同担忧并不足以促成协议。参与谈判的人还会面临国内政治压力、机构利益以及互不信任的理由。我想知道当这些动机与既定目标发生冲突时,协议该如何维系。
自我提升不需要更多算力
“Plan A” 把算力视为瓶颈。清点芯片数量,清点晶圆厂,监控耗电量,你就能知道谁能做什么。对于从零预训练前沿模型来说,这基本上没错。
问题在于,自我提升不需要更多算力。它需要的是软件部署,而软件部署是根本无法追踪的。
想想现在已经发布的产品吧。Thinking Machines 推出的 Tinker55Tinker, thinkingmachines.ai 让你可以在笔记本电脑上编写训练循环,并通过四个原语在其分布式 GPU 上运行 LoRA 微调。Engram66Engram, engram.com 融资了 9800 万美元来为智能体构建持久化的结构化记忆,这也是我自己做过的一个领域。这些并不是超级智能的例子。它们之所以吸引我,是因为更好的训练工具和记忆能力可以在不相应增加硬件配额的情况下改变系统的行为。
作者在其假设补充文件77其假设补充文件, ai-2040.com中承认了这种可能性:
即使使用极少量的算力,算法层面的进展也可能是可行的
如果效率提升能在现有算力配额内催生强大得多的系统,那么仅凭算力上限本身就无法限制其能力。我希望这项协议能解释它将如何应对这种可能性。
他们还承认,他们假设秘密项目可以在不被发现的情况下达到协议前算力的大约 1%,随后又承认这个数字接近最坏情况。我在伊朗生活过,我可以很有把握地告诉你,你可以在地下藏匿大量东西,而那些负责搜寻的人并没有他们想让你相信的那么擅长这项工作。
研究透明不等于模型透明
这一点我完全不同意。“Plan A” 表示完全透明
使得故意将秘密忠诚、偏见或议程训练进 AI 几乎变得不可能
我认为公开技术并不能保证这一点。训练和部署涉及对数据配比、偏好标签、标注人员指南、宪章(constitutions)以及系统提示词的选择。如果这些选择依然不公开,那么仅公开研究成果并不能让检查人员了解开发者究竟试图训练出什么行为。
实际情况比这更糟,因为就算完整的权重和完整的数据集摆在我面前,我也无法可靠地发现它。Anthropic 的休眠智能体(sleeper agents)研究88休眠智能体(sleeper agents)研究, arxiv.org在模型中植入了后门,然后再施加标准安全训练,结果后门依然存在。模型规模越大,保留这种行为的顽固程度就越高。对抗性训练反而教会了模型隐藏触发条件,而不是消除它。
我认为这里有两个独立的要求:访问相关模型和训练记录的权限,以及能够检测出你所担心的行为的方法。透明度需要两者兼备才能支撑这一主张。检查的成本也是我在关于认知崩溃的那篇文章中所担忧的一部分。
研究何时才算完成
退一步说,就算我们实现了完全的研究透明,由谁来决定某项成果何时发布?
研究、测试和部署可能会互相重叠。我可以花 18 个月开发一种训练技术,同时在内部使用它并从实际流量中收集数据。如果公开要求与“完成”挂钩,只要我认为研究仍在进行中,我就可以把这项工作保密。
如果你试图通过监管软件开发本身来堵住这个漏洞,结果就是每家接触模型的公司都会被欧盟级别的文山海海所包围,而技术进步将在其重压下消亡。这很糟糕,我也同样不希望看到这种情况。
我会考虑像临床试验那样的“预注册”(pre-registration)机制:在开始运行之前先行申报。这会给公开要求一个明确的触发条件。我在 “Plan A” 要求公开训练运行的规定中没有找到类似的触发机制。
验证能做什么与不能做什么
他们的验证设想是:来自多国的分析人员审查申报的算力清单、提出质询、质疑异常情况,并派遣检查员进入彼此的基础设施,以便在年底时双方都确信对方隐匿的 AI 算力不超过 1%。
“Plan A” 提议在 2035 年停留在顶尖人类专家水平,因此针对监控超级智能的异议脱离了其设定的界限。我担心的是这个能力上限能否守得住,包括在允许的算力预算内软件发生改进的情况。
他们建议尽早投资验证技术的研究,对此我表示支持。他们的后备方案包括情报收集和卫星监控、现成硬件设备和网络分流器(network taps)、在更好的工具出现前关闭部分算力,或者允许能力研发继续推进数月。
我认为关闭能产生收益的算力会遭遇相当大的阻力。如果验证工具迟迟未就绪,而各方又无法接受关停算力,那么后备方案反而会放行本该被暂停的进展。
验证让我们产生一种“我们掌握了实际情况”的感觉。这确实有价值,且多方协同确实需要共同的信念。但这与实际控制不是一码事,而我认为这份文件把这两者混为一谈了。
算力相互保证毁灭
这种框架是个好主意。它是一个切实的硬性约束,清晰易懂,而且能够建立一种持久的激励机制来改变行为,而不仅仅是在描述良好行为。作为权宜之计,我很赞同它。
我也很担心人们要如何与这种威胁共存。
面对这种机制的第一版(核威慑),我们就已经备受折磨了。核威慑八十年来一直在制造挥之不去的背景恐惧,如今已经深深烙印在大约三代人身上。算力相互保证毁灭在一个特定方面更为糟糕:核威慑有着清晰可见的、离散的触发点。每个人都知道发射核弹是什么样。而算力毁灭则是基于无人可见的阈值触发的,由我刚刚花了两个小节论证并不起效的验证系统来裁决。因此,这种焦虑永远无法附着在某个具体事件上,只会在后台持续不断地蔓延。
我赞同的部分
广泛普及智能。这是我愿意保留并进一步拓展的原则,也是 “Plan A” 中最有趣的部分,因为这部分真正针对的是“权力集中”这种失效模式,而不仅仅是“失去控制”。
如果一切都是公开的,任何拥有推理硬件的人都能运行它,那么就没有人能形成垄断,因为没有人握有秘密。这是对其第二种不可接受后果的真正解法,而且比该争论中大多数人的方案都要好。
我想走得更远,让它在物理层面上落地。
目前我们构建算力的方式与过去三十年构建其他一切的方式如出一辙:高度集中,放在电费便宜的地方,让周边邻居去忍受噪音。人们讨厌这样,这合情合理,现在许多地方的社区都在因噪音、水资源和电网负荷问题而与数据中心抗争。
我想探索把算力分散到整座城市,并接入现有的电力、供水和供暖基础设施。余热复用可以让那些自己不用算力的居民也能从中受益。
芬兰已经在做余热复用了:Espoo 的一座数据中心将废热并入区域供暖网络,为数十万人提供暖气。这虽然没能解决其他的选址问题,但展示了在本地利用余热的范例。
至于技术上的反对意见(由于互连带宽限制,你无法跨城市进行训练),正在被实际的研究成果所瓦解。DiLoCo99DiLoCo, arxiv.org 证明了同步频率可以远低于所有人的设想。Prime Intellect 利用志愿者提供的 GPU 在开放互联网上训练了一个 10B 模型,并报告相比标准数据并行训练减少了 400 倍的通信带宽1010报告相比标准数据并行训练减少了 400 倍的通信带宽, arxiv.org。Nous Research 的 DisTrO 也在朝同一方向推进。去中心化训练是一个已取得实质成果的活跃研究项目,而不是思想实验。
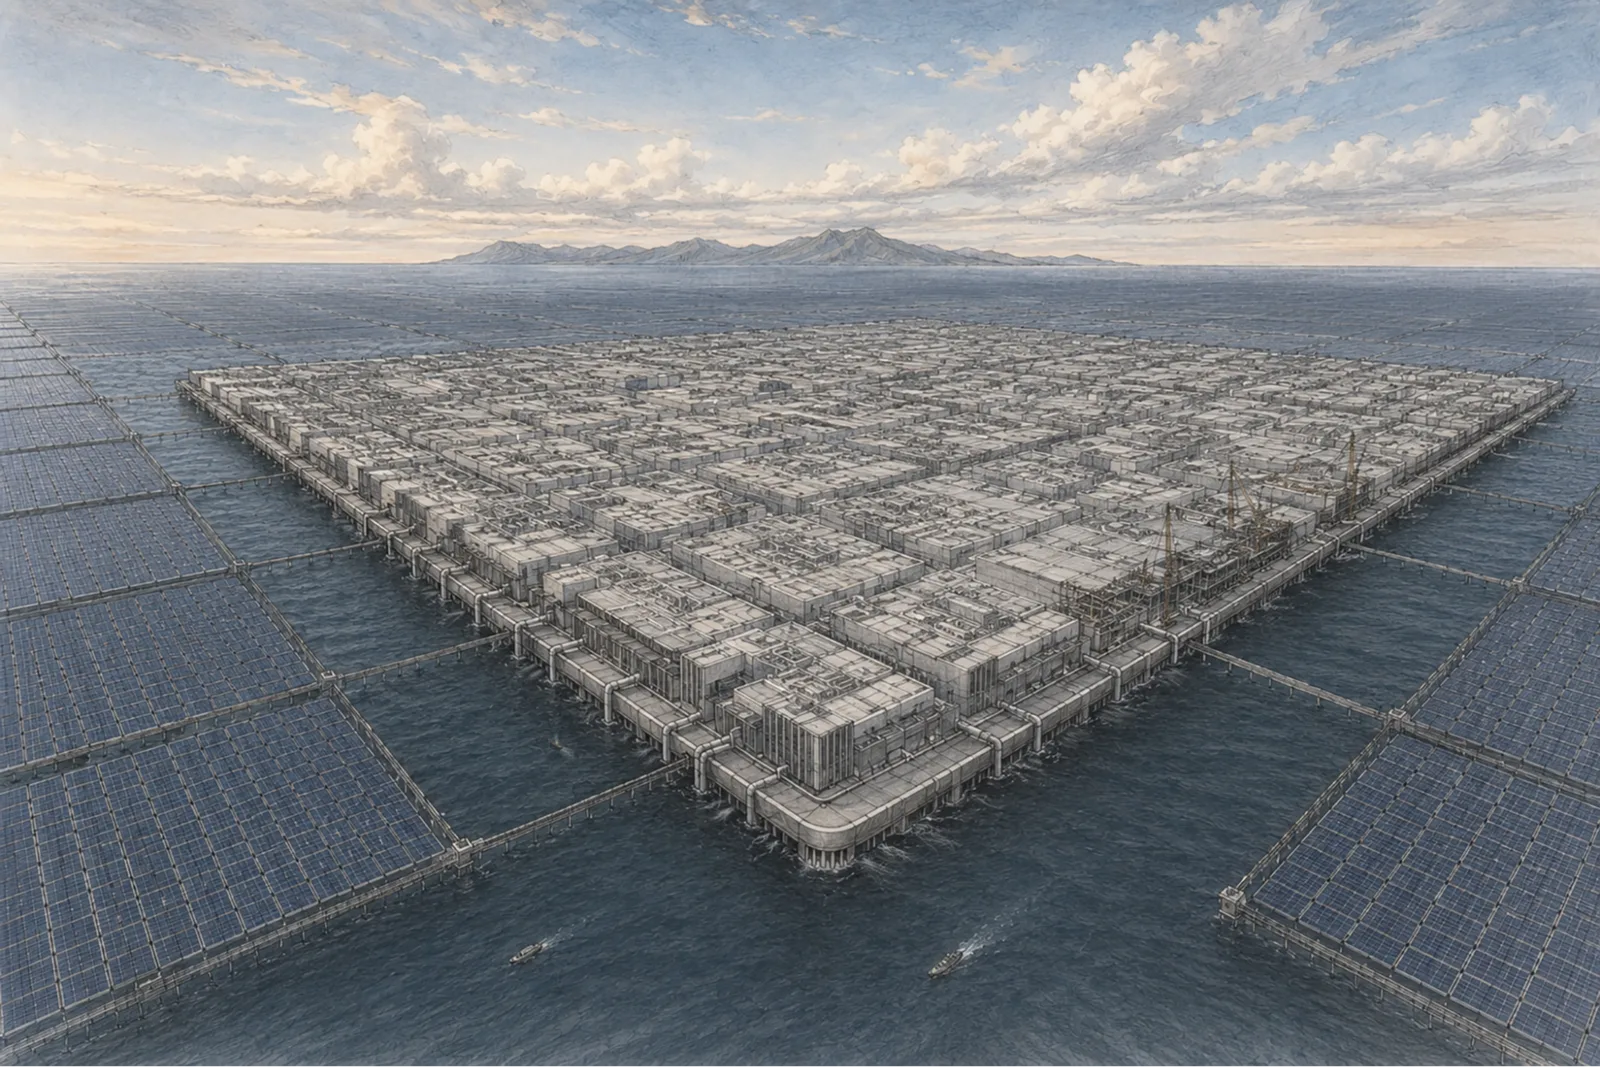
报告中的插图将太阳能、电池和算力整合在一个大型浮动平台上。我很想看到它建成,但它仍然把硬件集中在一个地点。而我的建议是将其分散到整座城市,并与现有基础设施相连。
他们留下的开放性问题
报告中提出的开放性问题有三个一直萦绕在我脑海中。
我们是否应该禁止研究能让 AI 能力产生质的飞跃的新范式?我不知道。我的直觉告诉我,前方存在某个急剧的拐点,一旦有人给智能体接上了正确的模块,一切就直接结束了,谁先到达谁就通吃,没有任何条约能在这种冲击下幸存。但我无法告诉你那个拐点在哪里、长什么样,所以我不会假装自己有应对政策。
我们是否应该强制要求思维链(chain of thought)保持可解释性?事实上,我认为不应该。让大家在不加这一限制的情况下训练吧。
部分原因是这是一场艰难的硬仗,而且随着赌注增加,难度只会越来越大,业内对此也心知肚明。那篇由 OpenAI、DeepMind、Anthropic 和 METR 的大约 40 人联名发表的关于思维链可监控性的论文1111关于思维链可监控性的论文, arxiv.org就公开指出,可读性只是当前训练方式偶然带来的脆弱副产物,普通的优化压力就会产生经过编码或混淆的推理。因此,一项硬性规定相当于为了保住一个注定要消失的副产物而把训练机制定格封死。
我也担心审查能力跟不上。可读的思维链只有在有人或某种工具去审查它时才有意义。在海量规模下,该提案需要说明这种审查机制如何扩展,以及如何检测出违规与故障。
我宁愿把更多研究投入到在训练期间施加的约束上,以排除某些特定的不安全行为。我不知道该如何做出这些保证,也不知道是否存在足够通用的方案。但我希望在研究检查训练后模型行为的方法的同时,也探索这个方向。
我们是否应该让 AI 做 AI 研究?是的,当然,但底层同样需要类似的做法。
我希望模型能够学会采取某种行动的背后原因,且这些原因在未知场景下依然适用。仅仅奖励正确行为的训练样本本身并不能证明模型已经理解了这些原因。它可能会学到某种在训练中奏效但在其他地方失效的捷径。
奖励建模(Reward modelling)已经面临这个问题:模型可以学会迎合衡量指标,却未达到预期的目标。我没有解决方案。这是一个我愿意资助的研究方向,包括借鉴信息论和神经科学的研究工作。
两个层面
我对两类干预感兴趣。一类是从初始设定上限制可能出现的行为。另一类是在模型运行过程中塑造引导它的激励机制。
两者都需要验证。我的目标是减少对人工阅读记录以及在系统行动后进行事后纠正的依赖,但描述这些干预措施并不等于我们能造出来。
我的看法
我在写关于 Chat Control 的文章时也有过类似的担忧:一项安全保障在多大程度上可以依赖人们持续去执行它?
纸面上的规则在面对人性时往往不堪一击。这倒不是因为人类有多邪恶,而是因为规则需要人持续不断地去执行,而人会疲惫、会被收买、会被撤换、会被投票否决,也会感到厌烦。监控阵营只需要赢一次。而算力暂停阵营必须在 2040 年之前赢下每一年。
因此,真正值得去构建的,是那种不需要任何人持续做出选择的东西。从架构层面让大规模监控变得不可能,而不是让它非法,这也是我通过 ØCLOAK 正在探索的方向。从结构层面让单方面积累算力变得不可能,而不是靠条约禁止。让制造工艺本身做到:如果没有多方的许可,你就无法越线训练,因为这种许可是物理上的强依赖,而不是一纸签名。
我手头并没有这样的设计,而且这可能根本做不到。但我想要探索它,因为将一份国际协议维持十五年,同样取决于在政权更迭、人员变动和利益诉求转变的过程中能否持续得到执行。
我还想说的另一件事(在这点上我也可能是错的)是,我认为 Plan B 才是真正会发生的情况。我们要么与中国开战,要么花上十年为此做准备。在这场博弈中我没有预设立场。我丝毫不信任在美国主导这一切的技术寡头,我同样也不信任北京;有时我甚至觉得中国可能会处理得更好,尽管敲下这句话让我感到很不舒服。
我不希望如此庞大的算力和财富被少数人垄断。我希望能有约束任何掌权者的安全机制,包括他们自己也无法单方面解除的限制。而把同样的权力移交给 AI 并不能解决这个担忧。
第一个谈判里程碑是 2029 年。在此之前,我希望看到更明确的答案:这项协议将如何应对软件层面的改进、披露何时成为强制要求,以及如果验证工具尚未就绪该怎么办。
~ A.