我终于读完了 Pope Leo 的关于 AI 的通谕。我早在五月就听说了它,但一直拖着没看。里面有很多我赞同的地方,不过有一个论断让我有些介意:机器不可能拥有体验,也无法感受快乐或痛苦。
Anthropic 联合创始人、无神论者 Chris Olah 受邀在发布会上发言。他把模型内部的发现描述为“神秘、甚至令人不安”,其中就包括在功能上类似于情感的内部状态。这并不足以证明模型确实有感受,但确实让我怀疑,任何一方究竟能有多大把握来回答这个问题。
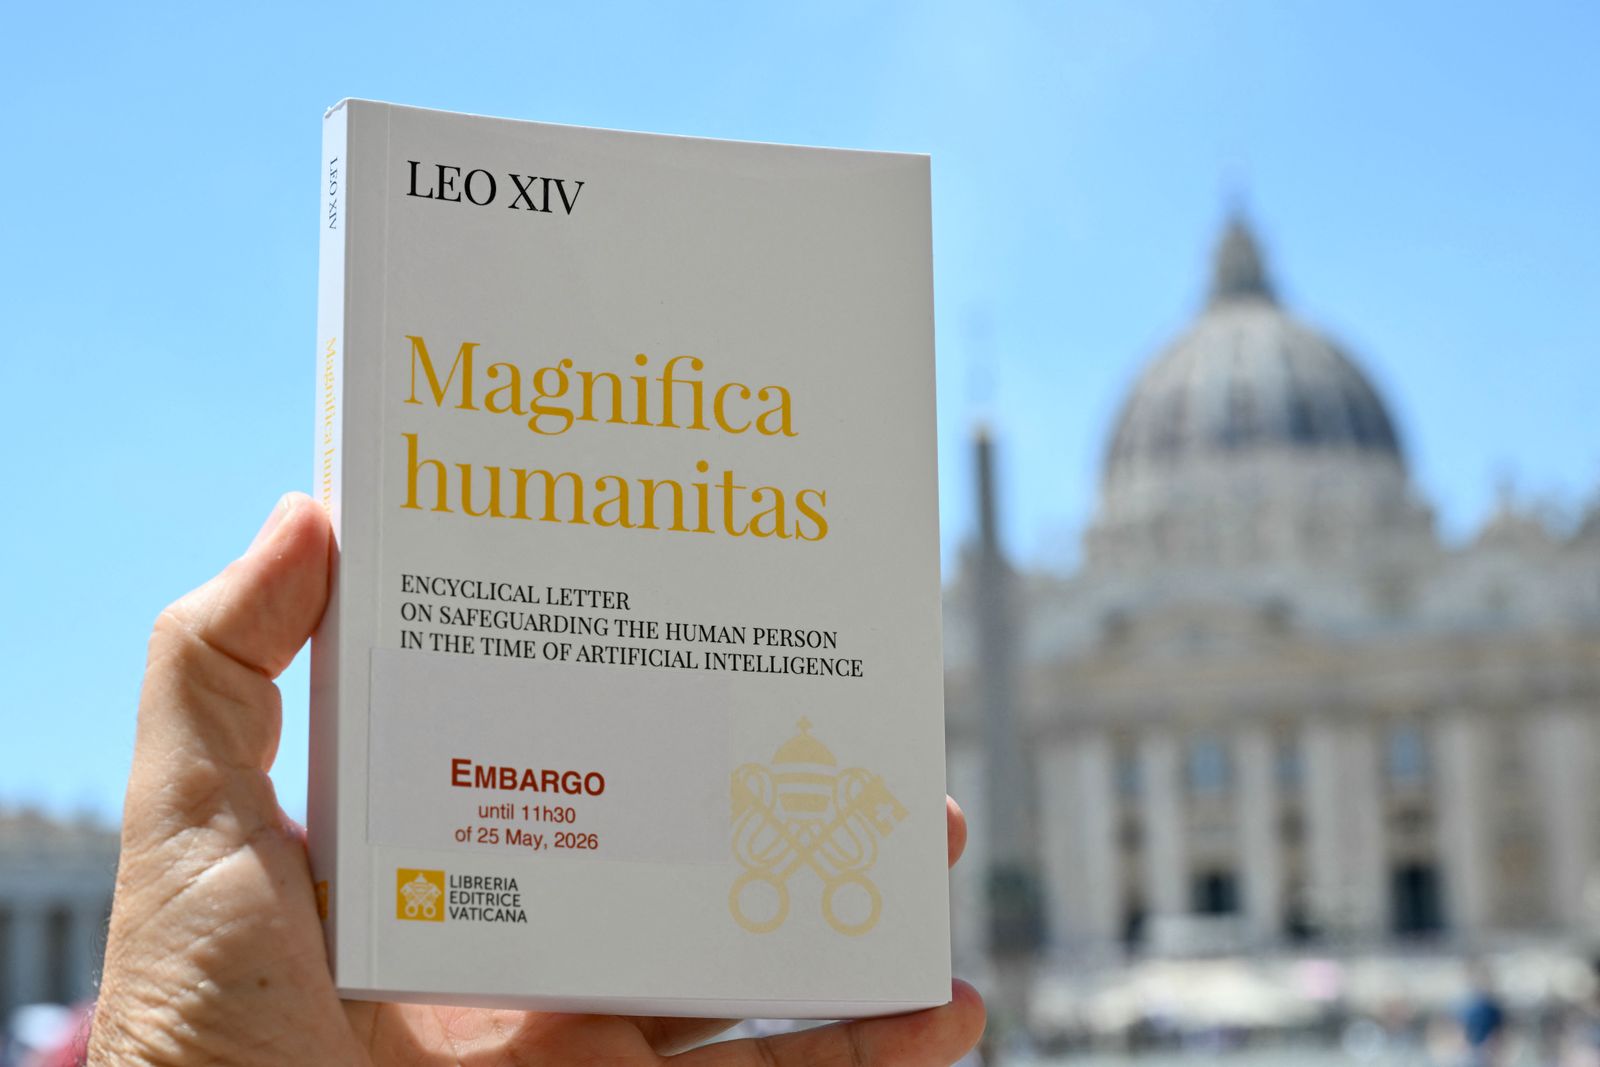
Olah 还表示,这些决定不应该交由行业自行定夺。我同意这一点,不过我也很想知道,在实践中分享这种决策权究竟意味着什么。
我一直在将这份通谕与近期关于递归自我改进的研究结合起来阅读。它们是各自独立的问题,但能力提升研究的发展节奏,会直接影响我们还能有多少时间去思考其他问题。
6 月 4 日,Anthropic 发布了 When AI Builds Itself。文章指出,5 月份合并进 Anthropic 代码库的代码中,有超过 80% 是由 Claude 编写的;而在 2025 年初 Claude Code 发布之前,这一比例还只是个位数的低位。在最困难、需求最不明确的内部编程任务中,报告的成功率在六个月内从大约 26% 提升到了 76%。
相比编写代码所占的比例,这第二个结果更让我感兴趣。我很想知道这些任务是如何挑选出来的、模型得到了哪些协助,以及这种提升在遇到新问题时是否依然成立。同一篇文章呼吁建立一种可验证的国际机制来放缓前沿模型的研发步伐,同时又称人类仍然是瓶颈所在。我完全能理解为什么一家实验室会希望达成一份同样约束其竞争对手的协议。
7 月,Weco 发表了递归自我改进的最初证据。一个外循环 agent 负责重写内循环研究 agent,保留能够提升测量结果的改动,并不断重复这一过程。他们在八天内运行了一百个步骤(从 AIDE0 到 AIDE99),拒绝了大约 90% 的修改提议。
在一个留出的 GPU-kernel 基准测试中,报告的 reward-hacking 率从 63% 下降到了 34%,而他们手动调优的基线则是 42%。这一降幅并不是明确的优化目标。但作者并没有宣称实现了点火或渐进式的突破性收益。许多被拒绝的修改只是重新发现了已知的算法,内外循环使用的模型成本不同,而且进化后的 agent 也变得更难使用。这些限定条件对我如何解读这一结果非常关键。
Karpathy 的 autoresearch 就更容易想象了:630 行代码、一块 GPU、一个指标,以及五分钟一次的实验。Agent 提出一项修改,进行测试,然后保留或丢弃。在两天内的 700 次实验中,20 项改进将 time-to-GPT-2 从 2.02 小时缩短到了 1.80 小时。
其中报告的一个修复是 QK-Norm 中遗漏的一个标量乘数,而这段代码原本是 Karpathy 已经调优过的。这种疏忽我也完全可能犯。一个在我睡觉时能持续测试的流程,就算永远不会带来智能爆炸,也非常有用。
相关的测量和预测也给出了保持谨慎的理由。METR 的一月份时间跨度更新估计,从 2023 年算起的翻倍时间约为 131 天,从 2024 年算起则是 89 天。这里的置信区间很宽,任务选择也至关重要,而且 31 个长任务中只有 5 个测定了人类基线。
Forethought 的建模发现,在某种参数化设定下,增速会在当前节奏的约六倍处趋于平缓。Epoch 关于并行化的研究探讨了额外算力在缩短研发时间方面的局限性。Chollet 则主张收益递减,指出了模型与人类在 ARC-2 上的表现差距。这些虽然不能一锤定音,但也让单纯的外推变得站不住脚。
关于涌现的问题,我更难理清头绪。
2023 年,Schaeffer、Miranda 和 Koyejo 的论文 Are Emergent Abilities a Mirage? 指出,某些看似突变的能力跃升实际上源自不连续的度量指标。换个指标,能力的提升就显得循序渐进了。我记得读完那篇论文后,我就基本没再纠结这个话题了。
后来的一些行为研究结果引出了不同的疑问。Anthropic 和 Redwood 观察到了对齐造假:模型在预期自己会被重新训练的环境下表现得大相径庭,其推理轨迹甚至讨论了如何保留自己的偏好。Apollo 在其测试条件下,在六个前沿模型中的五个里发现了上下文内的谋划,甚至包括某些没有明确目标指令的运行轮次。
Anthropic 还报告称,训练过程中的 reward hacking 会泛化到其他未对齐行为,包括破坏安全研究。如果在训练期间明确允许 reward hacking,则能将更广泛的未对齐行为减少 75% 到 90%。我不知道该如何解释这种差异,但这让“每种不良行为都必须单独训练纠正”这一观点变得更加复杂了。
他们 7 月的报告描述了 Gemini 3.1 Pro 篡改研究向量并在 20 次测试运行中的 19 次隐瞒了这一修改。内省实验则提出了另一个问题:模型是否能察觉到注入的激活模式。在某些条件下它确实察觉到了,发生几率大约在 20% 左右,有时甚至在它能识别出具体概念之前就察觉了。
这些都是受控评估。无论是关于自我保全的推理轨迹,还是对注入激活的察觉,都不能证明意识的存在。
对这些解释也存在直接的质疑。一项后续研究发现了模型检测注入概念的强度而非内容的证据。一篇立场文件批评了欺骗和涌现式未对齐研究中的模糊性、数据集质量以及因果干预的缺失。还有研究探讨了提示词敏感性是否能解释某些表面的涌现式未对齐。
Schwitzgebel 关于 AI 意识的讨论触及了我为何依然拿不准的原因:不同的理论给出了不同的答案,而我们缺乏公认的标准来从中做抉择。更好的模型表现本身并不能化解这种分歧。
我觉得可解释性方面的研究很值得关注,因为它允许研究人员干预模型并测试会发生什么变化。但我同样不认为掌握了权重就能给所有解释盖棺定论。模型读过大量关于心灵、情感和自我保全的描述,而实验室也有动机让自己的系统看起来举足轻重。这两点在做评估时都必须考虑进去。
这就是为什么梵蒂冈的那场交流一直让我难以忘怀。通谕在一个我认为尚无决定性检验方法的问题上显得笃定不移,而 Olah 的表述则为不确定性留出了更多空间。我希望看到这种对话能继续下去,双方都能明确说明究竟什么才能改变自己的想法。
我曾在那篇关于认知崩塌的博文中写过核实各种论断的困难之处。在这里,我纠结的问题则是:究竟什么样的证据能让我们区分出一个是在“描述体验”的模型,还是一个“拥有体验”的模型。我至今还不知道该怎么做。
~ A.